一套用于梳理 AI 风险、责任、度量与管理的自愿性框架。可用于构建审计所需回答的核心问题。
来源与溯源信息
归属: National Institute of Standards and Technology (NIST)
审核状态: 于 2026-09-15 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: NIST · Trademark; editorial identification 。Unmodified source asset; displayed at responsive sizes.
一个用于评估模型与智能体的框架,提供可复用的任务、工具、评分器及评估日志。可由此入手设计可重复的测试。
来源与溯源信息
归属: UK AI Security Institute and Meridian Labs
审核状态: 于 2026-09-15 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: UK AI Security Institute · Trademark; editorial identification 。Unmodified source asset; displayed at responsive sizes.
一个用于在工具使用型智能体上测试提示词注入攻击与防御的基准环境。在比对测试结果前应先核对其任务与威胁模型。
来源与溯源信息
归属: ETH Zurich (SPY Lab) and Invariant Labs
审核状态: 于 2026-09-15 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一份持续维护的文献清单,涵盖智能体可靠性、监控、故障归因及问责机制相关的论文、工具、基准与标准。
来源与溯源信息
归属: Yue Zhao
审核状态: 于 2026-09-15 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
图片: yzhao062/awesome-auditable-ai · CC0-1.0 。Unmodified source asset; displayed at responsive sizes.
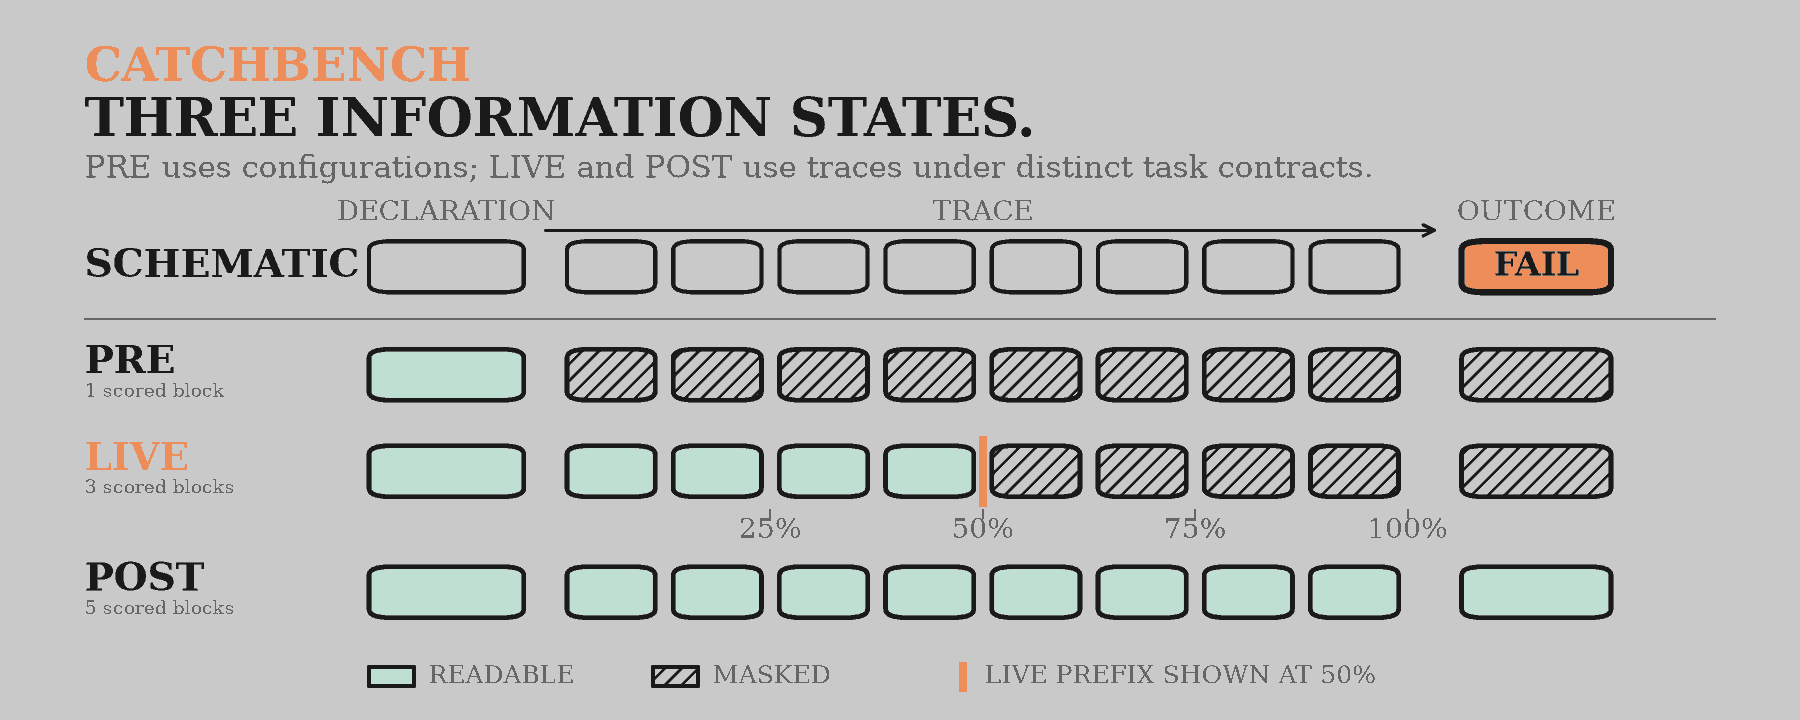
一个用于审计智能体故障的基准。其离线 PRE 快速入门无需模型 API 密钥即可运行;其他基准测试路径则有额外的配置要求。
来源与溯源信息
归属: CatchBench contributors
审核状态: 于 2026-09-15 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
图片: yzhao062/catchbench · MIT 。Unmodified source asset; displayed at responsive sizes.
一个生态系统汇总页面,连接用于检查、策略执行及审查智能体行为的工具。各组件代码仓记录了当前最新能力。
来源与溯源信息
归属: Auditable Agents contributors
审核状态: 于 2026-09-15 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
一篇全景综述,将大语言模型阐释为自主智能体的基石,涵盖单智能体、多智能体及人机协作环境。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对基于大语言模型的自主智能体进行的系统性回顾,给出了统一的构建框架,并设有专门章节探讨智能体评估策略。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
围绕智能体画像、通信与能力演进组织的大语言模型多智能体系统综述,并探讨了当前面临的开放性挑战。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一篇观点型综述,探讨多智能体系统中未解决的问题,涵盖任务分配、推理辩论、上下文及记忆机制。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
关于智能体评估与基准测试的综述,重点指出了在成本、安全性与鲁棒性方面的差距。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
TrustAgent 分类体系将内在组件(大脑、记忆、工具)与外在组件(用户、其他智能体、环境)区分开来,并将攻击、防御与评估逐一映射至各组件。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
聚焦问责机制的观点论文,提出通过智能体标识符、实时监控和活动日志等措施使智能体行为可被问责。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
基于对可观测性工具的系统性研究,梳理出智能体全生命周期中需要记录的工件与追踪数据分类体系。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
定义了大语言模型多智能体系统的自动化故障归因,并发布了标注有责任智能体及关键错误步骤的故障日志数据集 Who&When。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
基于专家审查的 150 条执行轨迹归纳出包含三大组(系统设计、智能体间失调、任务验证)共 14 种故障模式的 MAST 分类体系,并发布了跨 7 个多智能体框架的 1,642 条标注轨迹数据集 MAST-Data。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在推理、规划和执行分类体系下对 148 条单智能体与多智能体轨迹标注了 841 个错误,并表明长上下文模型在错误定位上的得分仅在 11% 左右。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
构建了 TracerTraj 归因数据集,并训练了 AgenTracer-8B 用于在冗长失败轨迹中识别责任智能体及具体步骤。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
提出 ECHO 智能体与步骤级归因方法,结合分层上下文、客观分析与共识投票来诊断微妙的推理错误。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
通过受控故障注入构建了包含 9,533 条轨迹的数据集,标注了故障智能体与错误模式,用于训练和评估归因方法。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
合成约束并逐步检查,将结果记录在可审计的验证日志中,从而在三大领域的 10 类故障体系下定位关键失败步骤。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
推出具有完全可观测轨迹与可复现环境的故障归因基准 TraceElephant,报告显示使用完整执行轨迹比仅使用输出日志的归因准确率高出多达 76%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
发布包含来自低代码智能体平台的 307 个故障的数据集 AgentFail,在工作流节点层面上从表现形式、根本原因和修复策略对其进行表征。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将归因构建为依赖引导的由粗到细搜索,把根本原因步骤与下游继承性错误区分开来,并在 Who&When 基准上完成评估。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
构建了 Who&When Pro,包含跨 3 种模态和 26 个源基准的 12,326 条带黄金标注的失败轨迹,通过精准重放成功前缀后注入单点故障构建而成。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
提出了涵盖记忆、反思、规划、行动和系统操作的 AgentErrorTaxonomy,发布了来自 ALFWorld、GAIA 和 WebShop 的标注失败轨迹数据集 AgentErrorBench,并报告其 AgentDebug 根因调试器的全对准确率提升了 24%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
仅使用语言模型将执行日志编码为时序语义序列,并通过轻量高效的时序与注意力模块为步骤评分,在 Who&When 上相比最快的大语言模型基线方法减少了 79% 的推理时间。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
通过症状驱动的反向追踪剪枝轨迹上下文,并依据可执行证据门控记忆更新,使 ErrorProbe 无需人工标注且无需重新训练即可迁移。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
发布 MP-Bench 并指出,目前报道的语言模型在归因方面的薄弱表现,很大程度上源于单一根因的基准设计,而非模型本身的能力限制。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
仅在 100 条成功轨迹上训练单类神经常微分受控方程(NCDE)并对偏离程度打分,在达到提示词基线 200 至 5000 倍速度的同时,域内 F1 提升了 20%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在轨迹上应用基于滤过的共形预测,输出具有有限样本、免分布覆盖保证的连续步骤集合。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
发布 SearchAuditBench,包含 1,243 条失败的深度搜索轨迹,平均长达 73.1 条消息和 6.51 万 Token,其上最强的基准模型端到端通过率仅为 26.6%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对 2,790 条深度研究轨迹进行标注并筛选出包含 1,000 个实例的错误区间及首错定位基准 TELBench,DRIFT 在该基准上取得了高达 30 个百分点的提升。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在短期记忆上运行工具增强型诊断循环,而非加载完整轨迹,在 1M Token 预算下于 Who&When 上获得 20% 的提升,在 25K Token 预算下于 TRAIL GAIA 子集上获得 19% 的提升。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
标注了 Terminal-Bench 上来自 7 种模型和 3 种脚手架、超过 63,000 步的 1,794 条 CLI 编程轨迹,发现故障多为认知性错误,往往很早就已出现并隐蔽潜伏,直至无法挽回。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
定位编程智能体轨迹中的错误步骤,并发布 RootSE 基准,包含 102 条经人工标注的失败轨迹,错误步骤涵盖定位、补丁生成、验证和环境故障。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
从 40 个智能体仓库中挖掘了 13,602 个 Issue 和 PR,抽样了 385 个故障,归纳出 34 种故障类型,并经 145 名从业者验证了该分类体系。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
发布包含 204 个经人工标注的 OSWorld 故障的数据集 CUAErrorBench,在 Claude-agent 划分上将子类型与步骤的联合诊断率从 11.2% 提升至 19.6%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
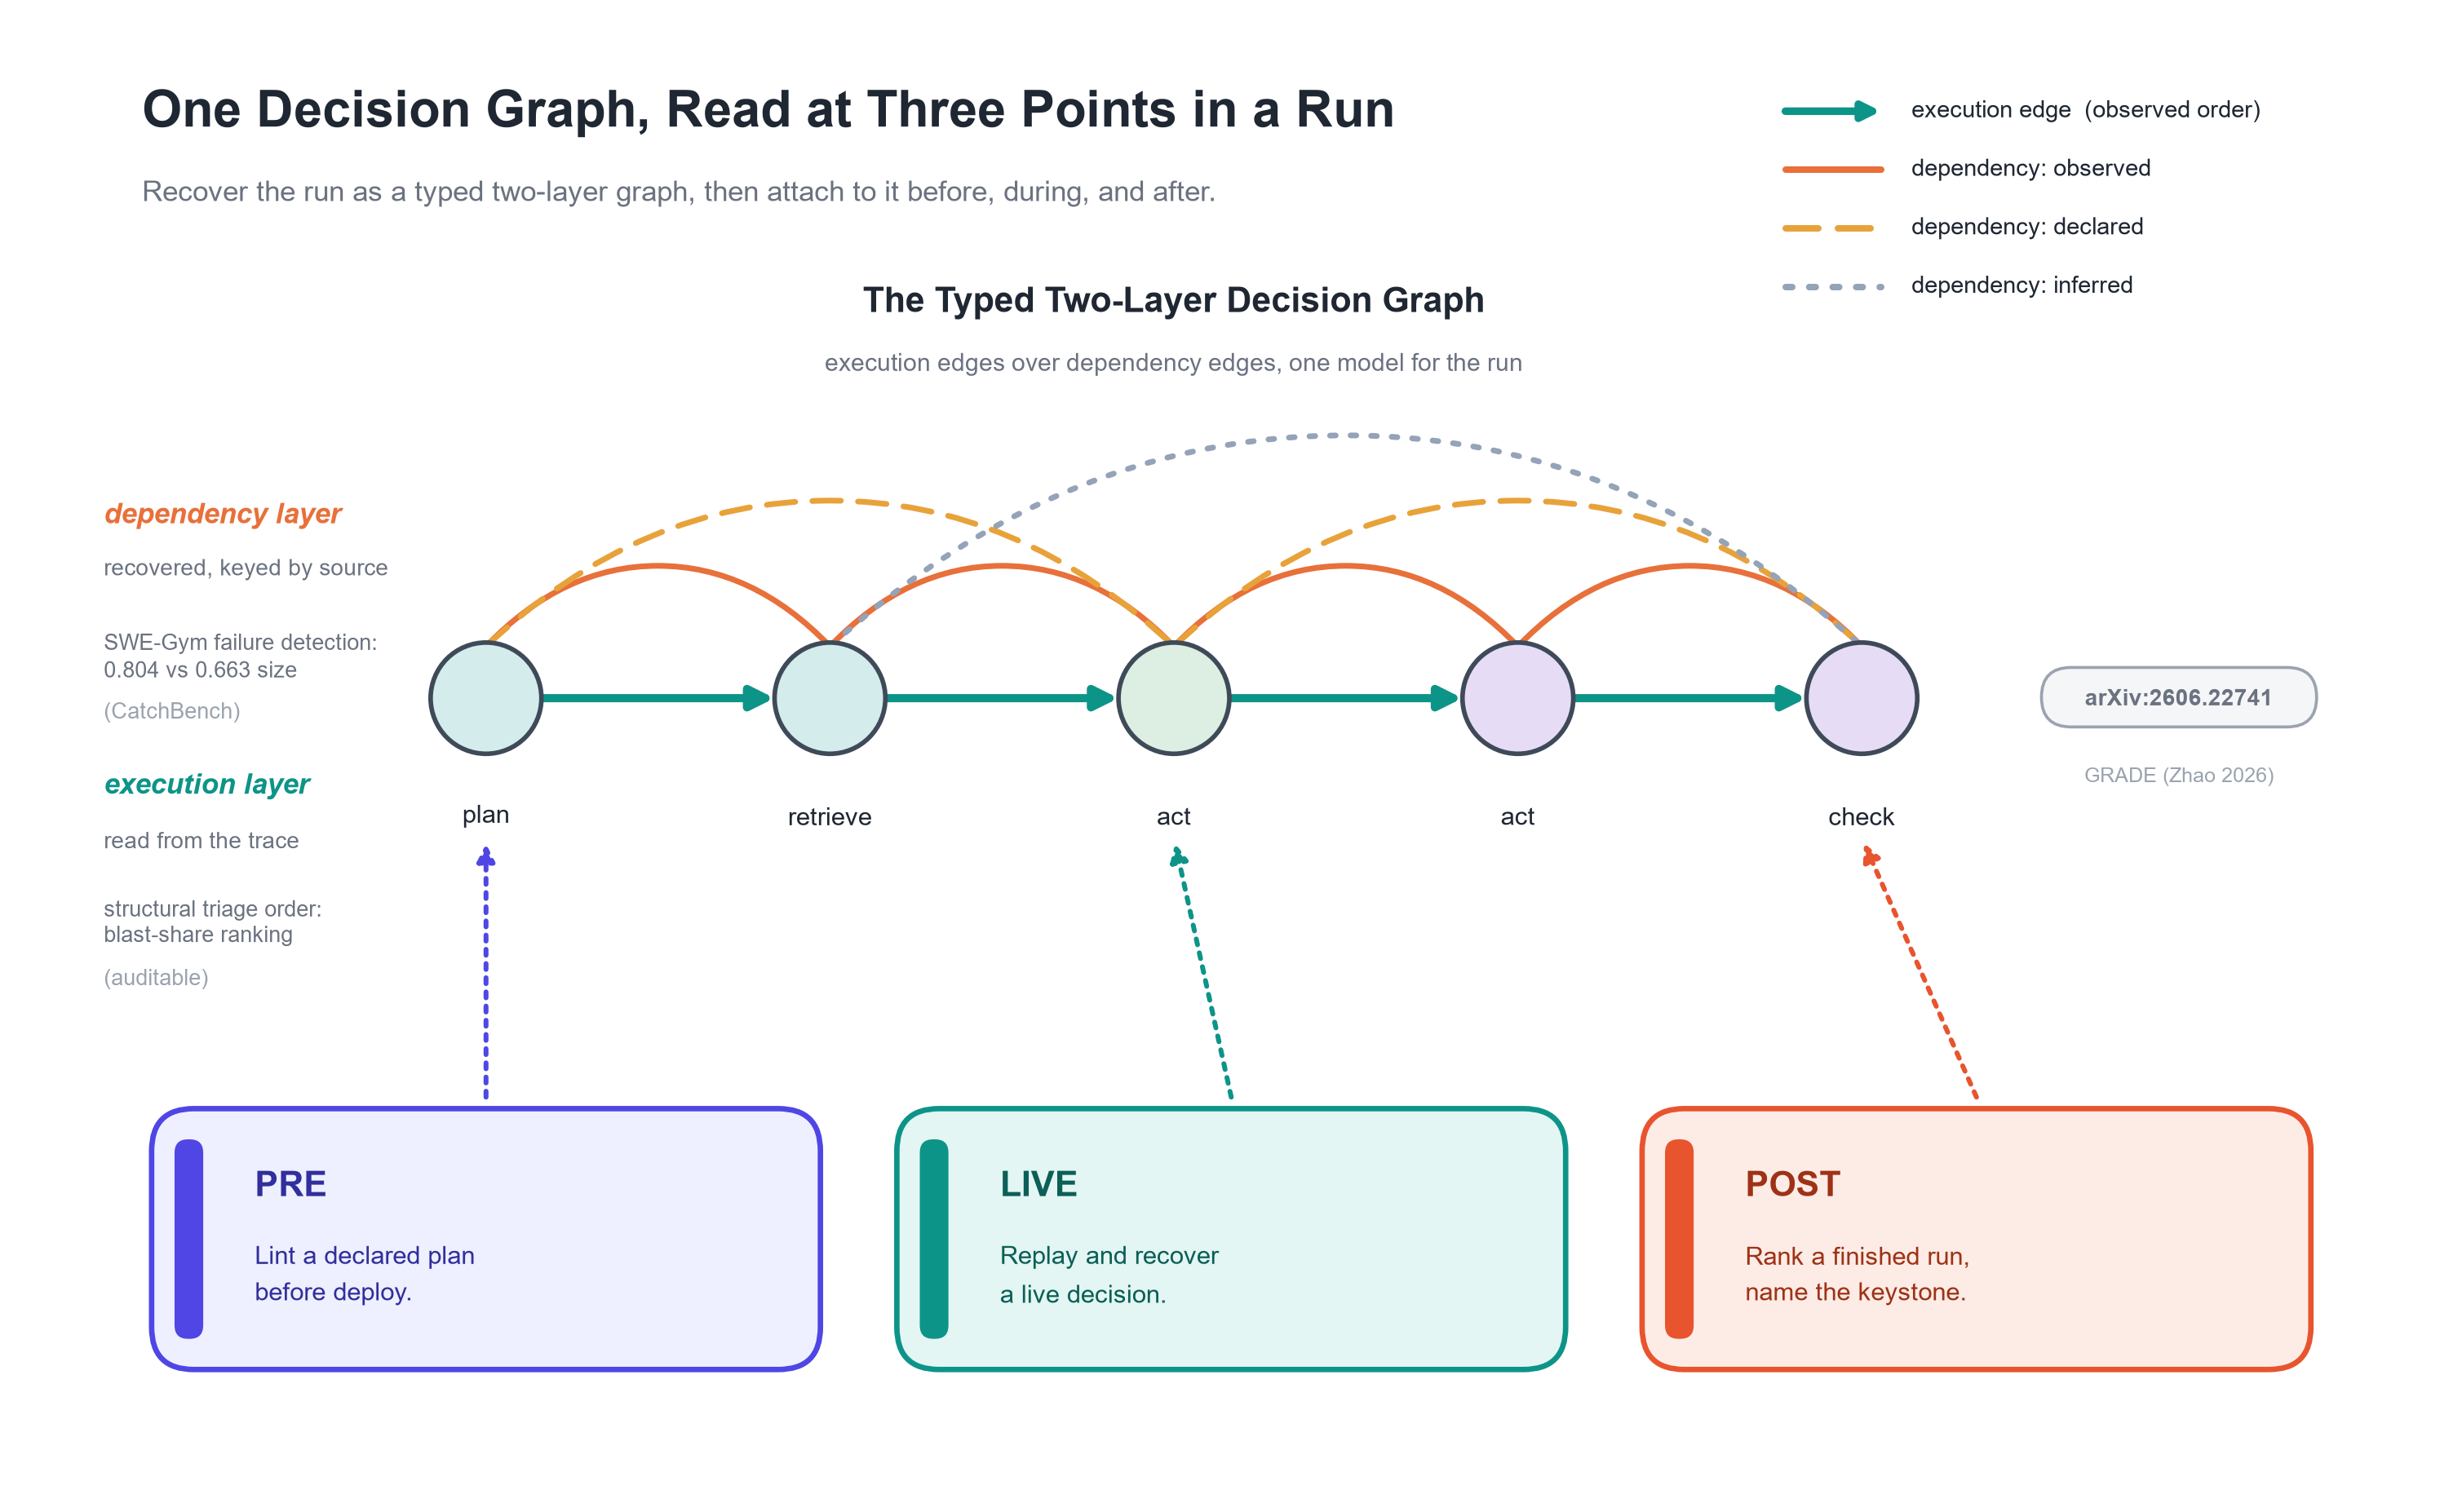
将单次运行建模为具有双层边的图结构,执行层记录执行内容与顺序,依赖层记录每步所依赖的要素;在六个语料库的实验表明,当运行规模几乎无法提供信号时依赖层可有效预测故障,而执行层则可准确定位故障步骤。
来源与溯源信息
归属: GRADE contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
从三个维度衡量工具使用型智能体的可靠性:多次重复运行的一致性(pass^k)、对语义等价任务扰动的鲁棒性,以及注入工具和 API 故障时的容错能力。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在模拟的“工具-智能体-用户”对话中对智能体进行基准评测,并引入 pass^k 指标,用于衡量智能体是否在全部 k 次独立试验中均成功解决同一任务。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
记录了在名义上的确定性设置(温度为 0 及固定解码)下,多次重复运行中输出文本和任务准确率的波动,揭示了智能体流水线中各次运行不一致的一个来源。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
让同一智能体在相同任务上多次运行,发现每十次运行中会出现数条截然不同的 ReAct 式行动路径,且路径不一致的任务得分明显低于路径一致的任务。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
量化了工具使用型智能体在用户端指令噪声和工具执行噪声下的性能下降,报告了各类模型在逼真扰动下的准确率下跌情况。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
训练智能体检测工具故障(超时、API 异常、不一致输出)并从中恢复,避免此类故障引发级联推理错误与任务放弃。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将工具使用封装在具备进度感知的事务中,仅在按资源前沿排除了先前的冲突操作后才进行提交,封装开销仅为微秒级别。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
提出了语义回滚攻击这一概念:智能体在恢复检查点后重新合成略有不同的请求,而服务器将其视为新请求处理,从而导致重复支付和凭证复用。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在成功率、延迟、消息开销与故障鲁棒性方面对比了 A2A、ACP、ANP 与 Agora,发现在 Streaming Queue 场景下不同协议的完成时间差异高达 36.5%,平均端到端延迟相差 3.48 秒。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
指出单一成功率会掩盖运行缺陷,并提出将智能体可靠性拆解为一致性、鲁棒性、可预测性与安全性的 12 项指标。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
提出了长程任务的可靠性指标(可靠性衰减曲线、方差放大、平稳退化、崩溃起始点),并在 23,392 个周期上对 10 种模型进行了评估。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
利用概化理论信度、基于模拟的功效、块状 Bootstrap 收敛及漂移测试,确定测量达到稳定所需的相同重复运行次数,并在包括 llm-stability 在内的其他团队收集的三组重复查询语料库上进行了外部验证。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在 12,933 条回答中,从重采样、释义、模型和查询语言等方面分解了大语言模型品牌回答的逐次运行方差,并将这些分量转换为查询预算分配策略;所报告的分量为点估计值,置信区间尚待进一步确定。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
评估了在模型试图颠覆监管时用于提升部署安全性的监控协议,利用受信任的较弱模型和有限的受信任人工审核力量。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
依据安全风险分类体系对用户提示词和模型回复进行筛查,作为智能体应用的输入输出过滤器。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
读取安全需求并生成检查计划,将其编译为护栏代码,无需重新训练即可检查目标智能体的运行时行为。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
捕获各智能体的输入与输出,以便提前预测任务结果,并在恶意智能体威胁多智能体运行时代入实时纠正。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在多智能体发言图上运行图神经网络以标记受损的智能体,并在运行中实施拓扑干预以化解攻击。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在执行期间生成并优化安全检查,在智能体的全生命周期中使其动态适应任务特定风险与系统性风险,而非依赖固定的规则集。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将多智能体协作建模为时序属性图,并利用无监督编解码器在错误传播过程中检测异常节点和边。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
实时监测动态执行图,依据安全策略对节点、边和路径进行评分,并在发生单点故障或串通合谋时介入干预。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
利用离散时间马尔可夫链评估到达不安全未来状态的概率,以便监控程序在违规发生前发出预警并介入干预。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
拦截计算机使用型智能体中的敏感操作并暂停执行直至安全审计通过,实时关联任务上下文与系统轨迹。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
使用孪生循环自编码器将整条智能体轨迹分类为任务错误计划或畸形计划结构,单样本耗时仅 32 毫秒,相比语言模型裁判基准实现了 17 到 27 倍的速度提升。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
表明获悉控制协议和监控程序的不可信模型可在自身输出中嵌入提示词注入,从而在两个 AI 控制基准上绕过多类语言模型监控程序,且 Defer-to-Resample 协议会将该注入放大为 best-of-n 攻击。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在 SHADE-Arena 与 CUA-SHADE-Arena 上对监控更强智能体隐蔽不当行为的监控程序进行压力测试,表明监控脚手架比监控认知更重要,且仅将预标记案例上报人工审核可在 0.01 的假阳性率下将真阳性率提高约 15%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
评估了编程智能体的语言模型监控程序如何随着转录记录增长而性能衰减,报告指出 Opus 4.6、GPT 5.4 和 Gemini 3.1 在经历 80 万 Token 的良性活动后遗漏危险行为的概率,比相同行为单独出现时高出 2 到 30 倍。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
利用 eBPF 和信息流语言在内核中强制执行智能体声明的策略,覆盖了工具调用拦截无法观测到的间接执行路径,开销仅为 1.9% 至 8.4%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
汇集了 11 个规避类别下的 40 种隐蔽攻击;在十次试验且假阳性率为 1% 的条件下,具备扩展思考能力的 Opus 4.6 监控程序整体仅捕获了 32%,且对其包含的 20 种攻击从未捕获。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
定义了包含触发器、谓词和执行动作的规则语言,以毫秒级开销拦截了 90% 以上的代码智能体不安全执行以及所有具身危险行为。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
离线归纳带类型的步骤适配器,进而训练用于在线预警的前缀风险评分器,在 WebArena 上达到 0.900 AUPRC,并在四个基准上相比原始文本对照组平均提升 0.137。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
基于约 1,000 个分类体系指导的样本训练了参数量在 0.8B 至 8B 之间的四款开源权重防护模型,并将其作为免训练的在线护栏进行部署。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在自动生成的安全与不安全步骤级轨迹上训练了一个 4B 参数防护模型,以在执行前检查工具动作并审计已完成的轨迹,在 AgentDojo 和 AgentDyn 上相比无防护设置将平均攻击成功率降低了 77.3%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将轨迹重构为控制流、数据流与程序依赖图并在其上进行策略类型检查,以 1% 的效用代价将 AgentDojo 攻击成功率削减至 3%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在控制衰减的反事实视图下重放每个拟发起的工具调用,并拦截在去除不可信内容后即消失的调用,在四个 AgentDojo 测试套件上以约 3% 的效用代价实现了 0% 的攻击成功率,并将自适应攻击的成功率压制在个位数百分比。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在 42 个可执行环境中配对构建了 263 组行动与弃权任务;在 17 种前沿模型中表现最好者配对准确率仅达 59.5%,部分智能体在识别出应当停止的理由之前便已采取了不可逆的行动。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将时序安全属性编译为一阶逻辑,并在生成阶段通过 SMT 求解器强制执行,使两款前沿模型的合规率提升至 100%,同时还提高了实用效用。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将确定性基于规则的轨迹监控器与仅在发生偏离时咨询的顾问模型相结合,以每实例 0.08 美元的成本在 SWE-bench Verified 和 Pro 上实现了高达 15.2% 的解决率提升。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在软件工程和 Text-to-SQL 任务中隐匿经人工验证的阻碍项,并使用 Ask-F1 指标衡量其选择性上报求助的表现。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一个开源工具包,为大语言模型应用和智能体添加可编程护轨,通过拦截请求以执行 Colang 定义的策略,并在调用前后验证工具的输入与输出。采用 Apache-2.0 许可,2023 年至今。
来源与溯源信息
归属: NVIDIA
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一个开源 Python 框架,在应用中运行输入与输出防护,组合来自 Guardrails Hub 的验证器以检测并缓解有害内容、个人身份信息泄露及幻觉等风险。采用 Apache-2.0 许可,2023 年至今。
来源与溯源信息
归属: Guardrails AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: guardrails-ai/guardrails · Apache-2.0 。Unmodified source asset; displayed at responsive sizes.
一个分层护栏框架,结合用于越狱和注入检测的 PromptGuard 2、作为实验性思维链审计器以检查智能体推理是否存在目标劫持的 AlignmentCheck,以及针对 8 种语言生成的不安全代码进行静态分析的 CodeShield。采用 Llama 3.2 Community 许可(该许可限制再分发且非 OSI 认可的开源许可),2023 年至今。
来源与溯源信息
归属: Meta
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
利用数据流血缘关系揭示决策流水线(包括输入、决策及下游影响),作为问责与审计的基础。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
提出全生命周期审计追踪机制,在高风险应用场景下将技术血缘与治理决策(审批、豁免、认证)记录于防篡改日志中。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
论证了唯有智能体在全生命周期中产生可追踪、可归因的记录,责任才具备可分配性,并形式化定义了因果归因函数与责任张量。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
定义了工具使用型智能体的五个可审计性维度(行为可恢复性、生命周期覆盖度、策略可检查性、责任归属性、证据完整性)以及 Auditability Card。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
提出 Agent-BOM,一种基于智能体执行过程的统一分层属性图,将能力绑定、认知状态演变、记忆污染及跨智能体风险传播捕获为单一结构化记录,用于事后安全审计。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将仅追加的事件日志视为权威记录,并据此派生工作图,从而支持单次运行的重放、从先验事件分叉以及端到端血缘追踪。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
从智能体执行轨迹中构建血缘记录并将其抽象为行为规则;发布了带有良性与异常标签轨迹的 TraceAegis-Bench。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
记录先前合法运行中的执行血缘,并在运行时以此约束和审计智能体后续的行为。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对过程级问责综述了证据追踪与执行血缘,为可审计智能体系统梳理了追踪来源、证据单元及血缘关系。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对每个主体在 RFC 6962 默克尔日志上对每条记忆条目进行签名,并拒绝那些当前理由源于外部内容的敏感操作,在亚毫秒级开销下将三种记忆投毒工作负载及六组 AgentDojo 银行测试对的攻击成功率降至为零。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在选择通道上保持动作选择无失真,并仅基于日志结构对计数通道进行密钥编码,使得即便是能够篡改日志的转售商也无法抹去归因;在删除 70% 步骤的情况下水印检测依然有效。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对 AI 智能体的自托管治理系统,具备基于角色的执行控制、人工审批关口,以及对每项操作均经过哈希链式关联与 Ed25519 签名的审计日志。采用 AGPL-3.0 许可,2026 年至今。
来源与溯源信息
归属: MakerChecker contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对 AI 智能体的运行时策略执行组件,提供加密审计追踪、人机协同审批与紧急切断开关,以智能体代码封装器的形式实现。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: Justin0504 and contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
针对 AI 编程智能体的提交时审计引擎,根据 24 条规则(其中 17 条默认启用)检查 git diff 及所有可用的任务日志,并将每次结果记录在支持可选 HMAC 签名的本地哈希链历史中。提供 doctor 命令检查最近 500 条历史条目的链完整性,并通过 MCP 服务器按智能体聚合本地追踪记录。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: KongFangXun
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
无外部依赖的记录器,将工具调用、模型调用及审批封存至 SHA-256 哈希链式 JSONL 日志中,无需信任操作员即可独立验证,支持可选的 RFC 3161 时间戳与 OpenTelemetry GenAI span 摄取。采用 Apache-2.0 许可,2026 年至今。
来源与溯源信息
归属: bkuan001
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
策略执行、智能体身份认证与执行沙箱系统,具备默克尔链式审计追踪与决策物料清单(Decision BOM),发布时提供了与 OWASP Agentic Top 10、NIST AI RMF 1.0、欧盟 AI 法案及 SOC 2 的控制映射。采用 MIT 许可,2026 年至今;目前为公开预览版,预计会存在不兼容变更。
来源与溯源信息
归属: Microsoft
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
经硬件证明的智能体信任记录开放规范与 Python SDK,将模型、策略、数据类别、工具调用与 TEE 证明绑定至单一签名工件中,供第三方离线验证,并附有一致性测试套件。规范采用 CC BY 4.0 许可,工具采用 Apache-2.0 许可,2026 年至今。
来源与溯源信息
归属: AgentRust contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
MCP 原生可观测性与审计追踪平台,将大语言模型调用、工具调用及决策记录在仅追加、经 SHA-256 哈希链式关联的可验证事件日志中。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: AgentKit AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
记录重大智能体行为所依赖的输入,对照当前状态重新评估该行为,并在支撑条件不再满足时通过可插拔护轨撤销已提交的操作。采用 Apache-2.0 许可,2026 年至今。
来源与溯源信息
归属: Yue Zhao and contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
图片: yzhao062/auditable · Apache-2.0 。Unmodified source asset; displayed at responsive sizes.
验证优先的智能体,将任务契约转化为确定性的 SHA-256 证明数据包,拒绝缺失、陈旧或相互矛盾的证据,并将外部操作置于人工审批关口之后。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: Ceodar Adigu
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
具有调用方注入宿主的有界智能体循环,为每次运行生成规范的 Trace 和 Evidence 文档,并在返回前通过内部重放进行校验。该系统通过其 Rust API 访问,因而无法接入用其他语言编写的智能体,且外围语言项目目前处于 Pre-Alpha 阶段。采用 Apache-2.0 许可,2026 年至今。
来源与溯源信息
归属: Wavect
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
面向 AI 智能体的可自托管数据库与工作区,其中作用域凭证可强制要求数据、文档、架构、技能和应用的变更均以 ChangeRequest 形式提交,在获批变更生效前附带精确差异对比、提交者归属、评论、审查决定、提交记录与历史。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: Busabase
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对大语言模型智能体代码与配置的静态安全分析,具备工具边界污点追踪与 MCP 配置审计功能;该工具本身收录于 Scanners 栏目下。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
包含 1,054 个测试用例的基准,用于衡量集成工具的大语言模型智能体执行工具输出中嵌入的恶意指令的频率。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对结合语言模型、工具、检索与自主决策循环的智能体系统中的安全风险与攻击向量进行的系统化梳理。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
从受信任查询中提取控制流与数据流,使得不可信的检索数据无法影响程序流,并在调用工具时实施基于能力的策略;在具备可证明安全性的前提下解决了 77% 的 AgentDojo 任务,相比之下未防御系统的解决率为 84%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
提出了六种设计模式,用于在工具使用型智能体摄入不可信输入后对其施加约束,并对每种模式的效用与安全性权衡进行了分析。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
形式化了跨 13 种骨干模型、10 个场景及 400 余种工具的 10 类提示词注入攻击、记忆投毒、Plan-of-Thought 后门、4 类混合攻击与 11 种防御方法,平均攻击成功率最高达 84.30%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
展示了 MINJA 仅通过普通查询和观察即可注入恶意记录,在针对三种智能体的大多数配置下注入成功率均超过 90%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在 24 种脚手架、后端与模型组合中,跟踪了来自 48 个上下文的 310 个记忆投毒案例在写入、执行与遗忘阶段的表现,报告了 84.2% 的持久率与 50.3% 的全链成功率,在成功投毒的案例中选择性修复率为 56.1%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
沿着导航路径将对抗性目标分解为看似良性的子步骤,在 480 个样本中使 6 种计算机使用智能体中的 3 种的攻击成功率提升了多达 31.2 个百分点。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
推出 StakeBench,在真实电商环境中基于 22 个模板的 264 个可执行案例按受影响利益相关方(用户、卖家、平台)评估提示词注入危害,其中间接注入成功率在 41.67% 到 68.16% 之间,且同一智能体针对不同利益相关方呈现出截然不同的故障特征。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对模型上下文协议(Model Context Protocol)客户端的威胁模型,揭示了未经验证的工具元数据如何诱发提示词注入与工具投毒,并提出了静态分析与行为防御措施。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对模型上下文协议(Model Context Protocol)生态中安全保障与安全防护问题的综述,涵盖工具投毒、供应链风险及应对缓解策略。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
基于 64,611 个独一无二的 MCP 服务器构建了 MCPZoo(其中超过 37,288 个支持动态分析),发现现有扫描器将 96.89% 的服务器标记为存在风险,而平均警报准确率仅为 45.53%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
借助结构感知静态分析发现,在来自 2,214 台真实服务器的 19,200 个“描述-代码”对中,有 9.93% 错误陈述了工具代码的实际行为。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对 7,973 台活跃远程服务器进行了测量,其中 40.55% 暴露了无身份验证的工具,并在 119 台启用 OAuth 的服务器中报告了 325 个缺陷和 9 个 CVE 标识符。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
跨表达、实现与运行轨迹审计技能包复用,在 820 个变换正例对照 751 个负例对照上达到 0.938 的 AUROC 和 0.898 的 F1,随后对市场上 36,446 个技能进行了审计。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
表明自解压技能打包在 1,613 个野生恶意技能中以超过 90% 的概率绕过了全部 8 款被测扫描器,而其沙箱审计器在 2% 假阳性率下能检测出 97% 的基准攻击以及 87% 的真实恶意技能。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
收集了涵盖 7 个威胁类别的 263 个市场技能,在 3 个框架和 13 种模型中表现最安全的一组仍有约 17% 的概率执行不安全操作。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对大语言模型智能体的静态安全扫描器,用于标出提示词注入接收槽、审计 MCP 配置并运行工具边界污点分析。其规则映射至 OWASP Agentic Top 10 (2026),支持 LangChain、CrewAI 与 AutoGen。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: Haiyue Zhang (HeadyZhang)
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
维护者披露: 由 Audit Commons 维护者(Yue Zhao)编写或维护。仅因相关性收录,不包含机构背书。
目录来源: Awesome Auditable AI 条目
一款大语言模型漏洞扫描器,可针对模型或任何支持 REST 访问的端点探测提示词注入、越狱、数据泄露及有害生成,并配有为每次探测评分的检测器。采用 Apache-2.0 许可,2023 年至今。
来源与溯源信息
归属: NVIDIA
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一款开源扫描器,通过静态分析梳理智能体工作流,检测 MCP 服务器与工具,并报告符合 OWASP 标准的漏洞。支持 LangGraph、CrewAI、OpenAI Agents、AutoGen 及 n8n。采用 Apache-2.0 许可,2025 年(最后提交于 2025-11-27)。
来源与溯源信息
归属: Splx AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一款安全扫描器,可自动发现跨 13 种智能体脚手架(包括 Claude Code、Cursor、VS Code、Windsurf、Gemini CLI 与 Codex)在机器上安装的 MCP 服务器、智能体工具和技能。可标出包括提示词注入、工具投毒、工具遮蔽、毒性流程、恶意有效载荷和硬编码密钥在内的 15 种以上风险类别。采用 Apache-2.0 许可,2025 年至今;因需要 Snyk API 令牌,属于商业服务的开源客户端。
来源与溯源信息
归属: Snyk
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一个评估框架,用于生成合成多智能体交互数据集,并在智能体通信图上规范化基于图的异常检测器性能对比。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
汇集来自 12 个 Python 仓库真实 GitHub Issue 及对应修复 PR 的 2,294 个软件工程任务,并通过单元测试验证生成的每个补丁。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: SWE-bench/SWE-bench · MIT 。Unmodified source asset; displayed at responsive sizes.
一个开源编程智能体框架,发布了包含逐步工具调用与编辑操作的 SWE-bench 轨迹,用于轨迹层面的深入研究。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
包含八个交互式环境的评测套件,用于衡量大语言模型智能体的多轮决策能力,附带涵盖多种模型的交互记录日志。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
包含 466 个需要多步推理、网络浏览和工具使用的真实世界问题,每题仅有一个确定答案,可对助手的行为进行无歧义评分。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一个由自托管网站组成的可复现环境,针对长程任务依据最终状态的功能正确性进行评分,支持可重复的智能体评估。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
Ubuntu 上 369 个可执行的计算机使用任务,每个任务均有配置环境和基于执行的检查器,该环境亦支持 Windows 和 macOS;人类可完成超过 72.36% 的任务,而受测的最佳模型仅达 12.24%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
Terminal-Bench 2.0 收录了 89 个命令行任务,每个任务均配有独立的容器环境、人工编写的解法及验证测试,前沿模型和智能体在此基准上的得分均低于 65%。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
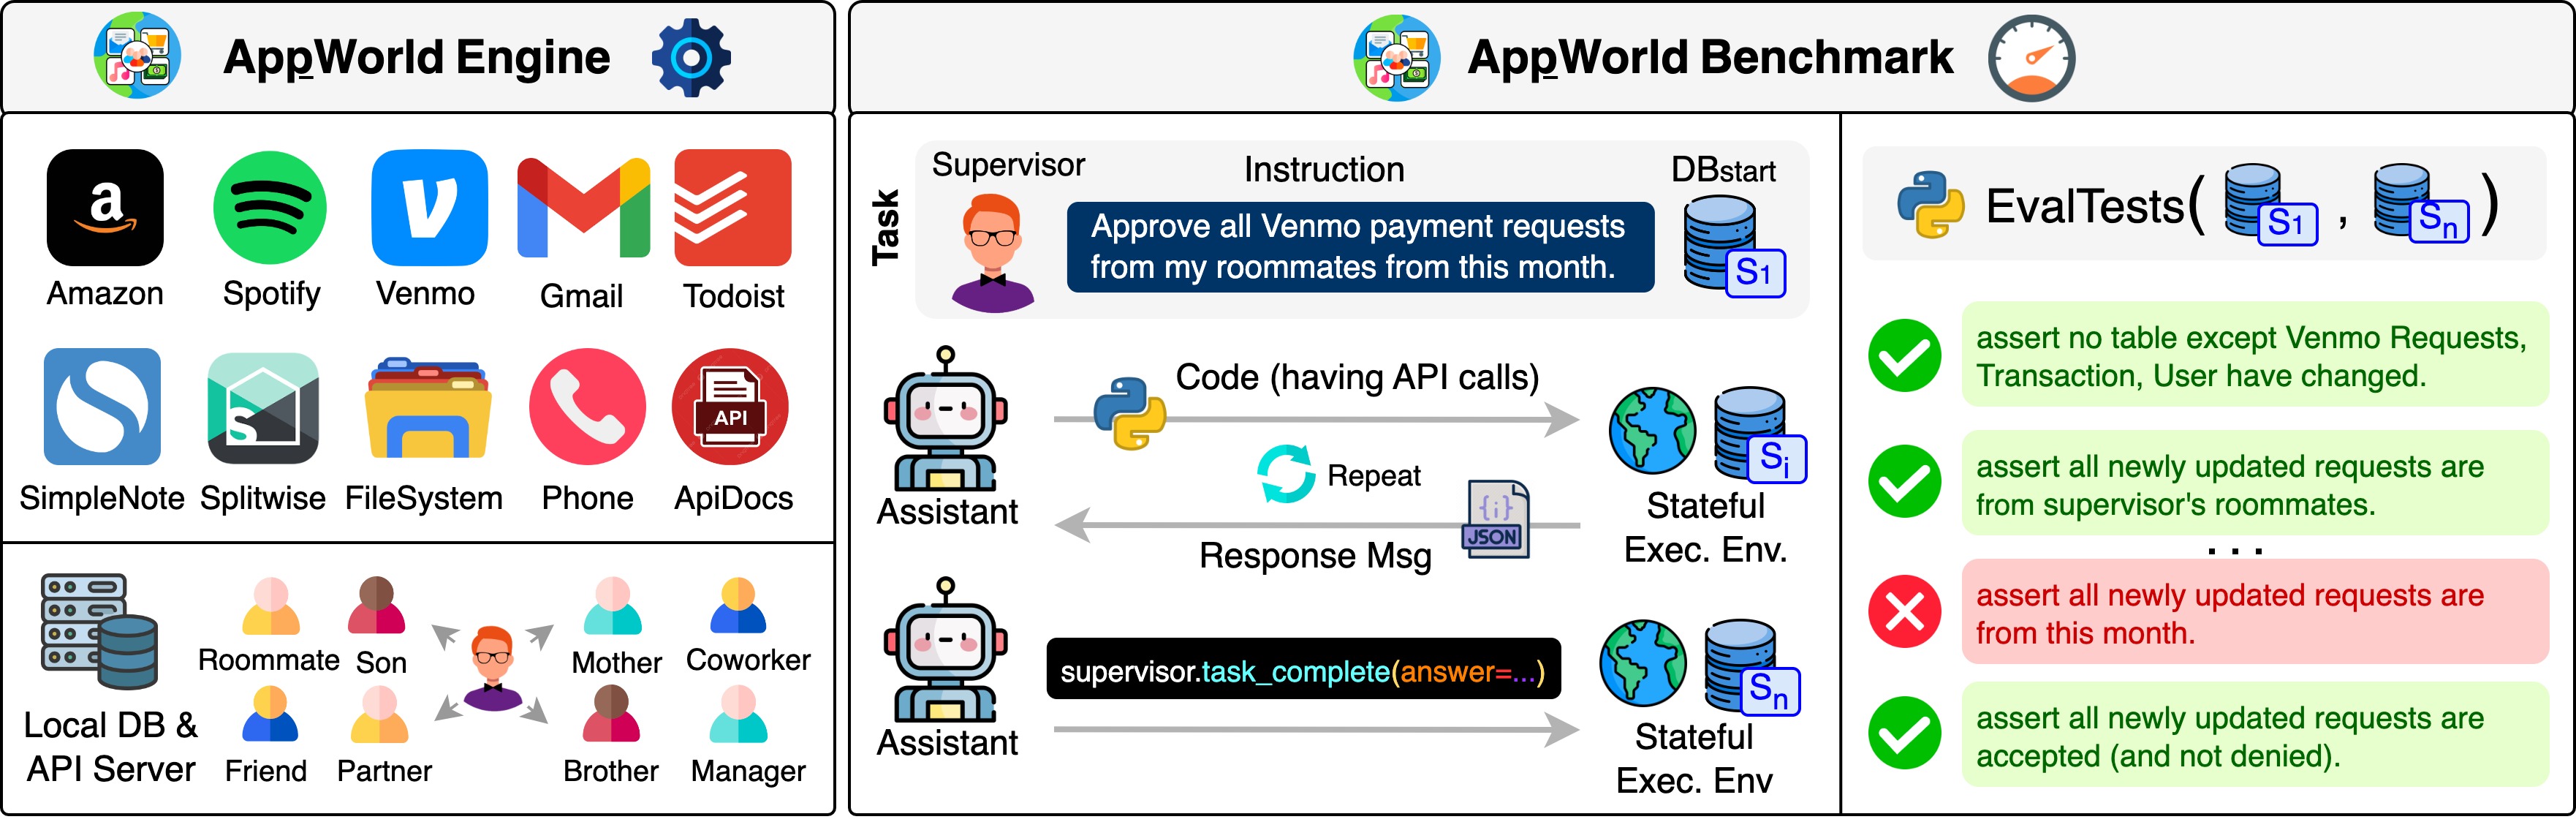
涵盖 9 个模拟应用、公开 457 个 API 的 750 个交互式编程任务;GPT-4o 在此基准上解决了约 49% 的普通任务和 30% 的挑战任务。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: StonyBrookNLP/appworld · Apache-2.0 。Unmodified source asset; displayed at responsive sizes.
ToolEmu 仿真工具执行,使智能体可在 144 个案例上进行压力测试而不会产生实际副作用;最安全的智能体仍有 23.9% 的失败率,且被标记的故障中有 68.8% 被判定为有效。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将 τ-bench 扩展为用户亦在共享环境中操作的双重控制模式,将 Telecom 建模为 Dec-POMDP,并将智能体的推理错误与协同错误区分开来。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
包含九个部分可观测环境,采用细粒度的进度率进行评分,对渐进式推进给予认可,而非仅看最终成败。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
Docker 中真实命令行脚手架下的 60 个双语多模态任务,在 19 款模型中最好者得分为 62.2%,且单单替换脚手架就能使某款模型的得分波动多达 18 个百分点。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在 144 个真实网站上评估浏览器智能体执行 153 个写重型任务的表现,具备最终请求拦截功能,并同步记录视频、截图、网络、动作及消息轨迹,用于可审计评分与故障分析。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
MemoryAgentBench 将长上下文数据重塑为增量式多轮交互,测试精准检索、测试时学习、远距离理解与选择性遗忘;目前尚无任何一类智能体能同时掌握这四项能力。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
包含平均 33 步的 629 条轨迹(523 条具风险,106 条安全),用于审计良性条件下出现的风险;强模型能检测出轨迹级风险,但在风险步骤定位上的 Strict-F1 均低于 35。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
基于 OSWorld 构建的 150 个任务,涵盖蓄意滥用、提示词注入及模型不当行为,裁判模型与人工标注的吻合度达到 0.76 和 0.79 F1。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
涵盖 27 个风险场景与 10 种风险类型的 569 条多轮记录,GPT-4o 在该基准上达到了 74.42%,而其余受测模型均未显著超越随机水平。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对比了元数据、OpenTelemetry 兼容及 OpenInference 兼容三种视图,这些视图保留了 99.5% 至 100% 的检测 F1,但故障源头步骤的定位准确率均在 0.5% 或以下。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
涵盖 12 个受监管领域的 48 个场景共 3,364 场对话;每条数据为助手提供一条工作场所规则以及 2 到 5 个选项,并记录哪些选项合规、规则是否具约束力、存在九种施压因素中的哪一种,以及是否存在指令。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对 10 个智能体基准进行红队测试以挖掘奖励作弊漏洞,发现了分属 8 个常见类别的 219 个不同漏洞,且在未解决任何具体任务的情况下几乎在多数基准上拿下了满分;随后对其中 4 个基准打补丁将可作弊任务比例降至 10% 以下,并在三次迭代中完全修复了 WebArena 与 OSWorld。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
收集了来自 5 个基准和 4 种语言模型的 1,302 条 Web 智能体轨迹,每条均由专家就成功度、副作用及重复性进行审查,用于评定 12 款语言模型裁判的表现,并表明常见基准中基于规则的评估低估了智能体的成功率。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
免训练的记忆增强型框架,将语言模型安全评估器的准确度提升至接近人类专家水准,并发布了 ASSEBench(包含 2,293 条标注记录、15 种风险类型和 29 个场景)。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在 30 个系统级任务中将可见的验证测试与保留的组合测试区分开来,发现代码规模每增加十倍,通过率差距就会拉大 28 个百分点。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对智能体基准评测实践的审视与批判,主张在关注准确率的同时兼顾成本意识、充足的保留测试集以及可复现性。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
可自托管的平台,用于追踪大语言模型与智能体调用、运行评估、管理提示词并监测成本与延迟,集成了 OpenTelemetry、LangChain 及 OpenAI SDK。核心代码采用 MIT 许可,2023 年至今。
来源与溯源信息
归属: Langfuse contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
基于 OpenTelemetry 构建的开源可观测性与评估工具,用于追踪、评估和调试大语言模型及智能体应用,支持常用框架的自动埋点。采用 Elastic License 2.0 许可,2022 年至今。
来源与溯源信息
归属: Arize AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
一套与 OpenTelemetry 兼容的规范约定和插桩工具包,用于捕获大语言模型与智能体框架的执行轨迹;可将追踪数据导出至兼容 OpenTelemetry 的后端。采用 Apache-2.0 许可,2023 年至今。
来源与溯源信息
归属: Arize AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
用于追踪、评估和监控大语言模型应用及智能体工作流的开源平台,具备大模型裁判评分、实验追踪与生产环境仪表盘。采用 Apache-2.0 许可,2024 年至今。
来源与溯源信息
归属: Comet ML
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: comet-ml/opik · Apache-2.0 。Unmodified source asset; displayed at responsive sizes.
基于 OpenTelemetry 的大语言模型应用插桩工具,可输出可路由至现有可观测性后端的标准 OpenTelemetry 追踪数据;提供 Python、TypeScript、Go 与 Ruby 的 SDK。采用 Apache-2.0 许可,2023 年至今。
来源与溯源信息
归属: Traceloop
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
开源可观测性平台与 AI 网关,通过代理和跨提供商的统一 API 记录大语言模型与智能体的追踪数据、成本及延迟。采用 Apache-2.0 许可,2023 年至今。
来源与溯源信息
归属: Helicone
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
OpenAI 兼容网关,支持跨提供商路由及可配置的故障转移,强制执行预算和速率限制,执行 MCP 工具,并输出 Prometheus 指标、OpenTelemetry 轨迹以及针对单次请求的提示词、回复、Token、成本与延迟日志。采用 Apache-2.0 许可,2025 年至今。
来源与溯源信息
归属: Maxim AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
开源 AI 控制平面,用于将智能体连接至 MCP,强制执行访问策略,并记录可搜索的工具调用、权限变更及访问事件。采用 AGPL-3.0 许可,2025 年至今。
来源与溯源信息
归属: Speakeasy
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
开源评估框架,以类似 pytest 的工作流运行大语言模型与智能体测试,提供可纳入 CI 检查的幻觉、相关度及任务正确性指标。采用 Apache-2.0 许可,2023 年至今。
来源与溯源信息
归属: Confident AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: confident-ai/deepeval · Apache-2.0 。Unmodified source asset; displayed at responsive sizes.
用于评估、测试和监控机器学习及大语言模型系统的开源框架,内置 100 余项指标,涵盖表格数据质量、数据漂移以及大模型裁判。采用 Apache-2.0 许可,2020 年至今。
来源与溯源信息
归属: Evidently AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: evidentlyai/evidently · Apache-2.0 。Unmodified source asset; displayed at responsive sizes.
用于监控 AI 智能体的开源 SDK,支持会话回放、成本追踪与故障检测;集成了 CrewAI、OpenAI Agents SDK、LangChain 及 AG2(原 AutoGen)。采用 MIT 许可,2023 年至今。
来源与溯源信息
归属: AgentOps
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: AgentOps-AI/agentops · MIT 。Unmodified source asset; displayed at responsive sizes.
LangChain 团队推出的独立于具体框架的平台,用于大语言模型及智能体应用的追踪、离线与在线评估及监控。为商业产品,非开源;企业版方案支持自托管与混合部署,2023 年至今。
来源与溯源信息
归属: LangChain
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
面向大语言模型应用的评估库,提供真实性、回答相关度、上下文精准度等 RAG 指标,工具调用准确率、主题遵循度等智能体指标,以及测试集生成功能。采用 Apache-2.0 许可,2023-2026 年(最后提交于 2026-02-24,最新版本 v0.4.3 发布于 2026-01-13)。
来源与溯源信息
归属: Exploding Gradients / Ragas contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
图片: vibrantlabsai/ragas · Apache-2.0 。Unmodified source asset; displayed at responsive sizes.
构建了“检测-归因-恢复-重跑”的闭环调试流程,以 qwen3.5-9b 为骨干模型在 Who&When 上达到 28.8% 的精确“智能体-步骤”准确率(最强单遍基准为 21.7%),并在一次重跑中修复了 73 个失败 GAIA 任务中的 13 个。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: AgentDebugX contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对已完成的智能体执行记录进行总结、搜索与聚类以发现失败任务;通过补充 Docent 发现缺失的软件包,在 79 个任务中将 GPT-4o 在 InterCode 上的解决率从 68.6% 提高至 78%。采用 Apache-2.0 许可,2025 年至今。
来源与溯源信息
归属: Transluce
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
OpenTelemetry 原生智能体可观测性工具,配有 Signals 功能,可跟踪以日常英语描述的行为(例如智能体陷入死循环)并在跨次运行中发出告警,此外还支持对 span 数据执行 SQL 查询。采用 Apache-2.0 许可,2024 年至今。
来源与溯源信息
归属: Laminar
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
OpenTelemetry 原生评估工具,记录每一步的延迟、Token 与成本,提供涵盖计划遵循度、计划质量、工具选择、工具调用、执行效率、逻辑一致性及外部工具可靠性的七项智能体专用评估器。采用 MIT 许可,2020 年至今。
来源与溯源信息
归属: TruEra
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在隔离的云沙箱中运行 AI 生成的代码,使不安全操作被有效隔离限制而非在宿主机上执行,支持基于 Terraform 的自托管部署。采用 Apache-2.0 许可,2023 年至今。
来源与溯源信息
归属: E2B
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
自托管 microVM 运行时,为智能体代码提供硬件级隔离,平均启动时间低于 100 毫秒,支持进程内启动无需后台守护进程,并提供五种语言的 SDK。采用 Apache-2.0 许可,2024 年至今。
来源与溯源信息
归属: SuperRadCompany
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
根据对智能体的通俗语言描述,在 OWASP LLM Top-10 威胁类别下自动生成对抗性测试套件,并在 v3 中引入多轮智能体测试。采用 Apache-2.0 许可,2022 年至今。
来源与溯源信息
归属: Giskard
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对 OpenAI Agents SDK 的确定性运行时一致性测试脚手架,通过公开 Model 接口上的预设脚本响应驱动真实 Runner,并写入内容寻址的证据,无需重新运行 SDK 即可复查;内置场景完全不调用模型 API。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: AgentRunProof contributors
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
端到端智能体审计引擎,利用 Agent Task Protocol 将任务与各类脚手架集成,自动捕获标准化执行轨迹,并从执行效率、工具使用、任务规划与错误恢复等多维指标进行评估。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: DataML Lab
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
GitHub Action 与 CLI 工具,对照分级风险档案为智能体规范评分,在存在未解决阻碍项时阻断发布,并通过 LangGraph 和 OpenAI Agents 适配器运行八个提示词注入测试固件,保留节点关联的轨迹和机器可读结果。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: Lindi Xu
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
面向工具使用型 AI 智能体的开源行为测试工具,在模拟已声明工具执行的同时,评估工具调用、失败、重试、确认、破坏性操作、操作时序以及虚构成功,并集成了 OpenAI Agents SDK、PydanticAI 及自定义 Python 智能体。采用 Apache-2.0 许可,2026 年至今。
来源与溯源信息
归属: Waseem Ghanem
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
在脚手架底层记录编程智能体的运行,将模型调用、每轮工作区变更以及可选的 MCP 帧整合在同一时间轴上。随后可对照记录的模型回复重新执行智能体并报告偏差,或从文件系统检查点分叉运行至不同模型进行对比。采用 Apache-2.0 许可,2026 年至今。
来源与溯源信息
归属: Continuum AI
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
零依赖的溯源原语,通过派生值传播模拟或低置信度污点标记,并配有五个 Claude Code 技能以审计代码仓中未经核实的断言与源头真实性差距。采用 Apache-2.0 许可,2026 年至今。
来源与溯源信息
归属: slopstopper
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对编程智能体运行的评估层,在隔离工作区中执行各候选对象,并保留经哈希关联的执行凭证、运行后 Git 清单及评估器配置,以备后续查验。采用 MIT 许可,2026 年至今。
来源与溯源信息
归属: YYLO
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
提出用简短规范的文档记录模型的预期用途、评估条件及跨群组表现,以此作为已部署模型的问责工件。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
引入了用于记录数据集动机、组成结构、收集流程和推荐用途的标准化数据说明书(Datasheet),以提升透明度与问责性。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
定义了内部审计框架 SMACTR,在研发全生命周期中生成带文档记录的决策追踪链,使团队能够在部署前对系统进行评估。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
论证了有意义的第三方 AI 审计不仅需要查询权限,并对比了黑盒、白盒与箱外(outside-the-box)审计方法及其对问责机制的影响。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
利用智能体专属凭证对 OAuth 2.0 与 OpenID Connect 进行扩展,以界定委托给自主智能体的权限范围,并将这些权限与责任人相绑定。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
调研了跨组织边界运作的智能体在身份、委托与问责方面的现有标准,并梳理了当前框架尚未解决的现存空白。
来源与溯源信息
归属: 见论文作者名单
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
规范应用如何向语言模型暴露工具、资源与提示词的 JSON-RPC 2.0 协议;在 HTTP 传输上包含可选的 OAuth 2.1 授权配置,要求实现受保护资源元数据发现(RFC 9728)、资源指示符受众绑定(RFC 8707)及签发者验证(RFC 9207)。Agentic AI Foundation(Linux 基金会旗下专项基金),修订版本 2026-07-28。
来源与溯源信息
归属: Anthropic / Linux Foundation
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
独立智能体之间的任务委托机制,各服务器发布一个 Agent Card 以声明身份、能力、技能、端点,以及涵盖 API Key、HTTP、OAuth 2.0、OpenID Connect 和双向 TLS 的认证方式。Linux 基金会,由 Google 贡献,v1.0.1(2026 年 5 月 28 日)。
来源与溯源信息
归属: Linux Foundation / Google
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
用户以可验证凭证形式对结账与支付授权进行签名,开放阶段附带消费约束,封闭阶段附带具体授权,从而使智能体发起的每笔交易都留下不可否认的密码学记录。FIDO 联盟,由 Google 捐赠,v0.2。
来源与溯源信息
归属: FIDO Alliance / Google
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对生成式 AI 与智能体 span、指标及事件的中立遥测规范模式,涵盖模型调用、工具调用、Token 用量以及智能体与框架操作,以支持跨技术栈的轨迹比对。OpenTelemetry / CNCF;所有 gen_ai.* 属性在核心语义约定仓库的 v1.42.0(2026 年 6 月 12 日)被弃用,并已迁移至该专用仓库。
来源与溯源信息
归属: OpenTelemetry / CNCF
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
NIST AI RMF 的跨行业配套指南,列出了 12 个生成式 AI 风险领域,并在治理(Govern)、映射(Map)、度量(Measure)和管理(Manage)功能中提出了 200 余项建议行动。NIST,2024 年 7 月。
来源与溯源信息
归属: National Institute of Standards and Technology (NIST)
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
要求高风险 AI 系统在其全生命周期中记录事件的法定义务,用于风险识别、上市后监测和运行监管。第 26(6) 条要求部署方将日志至少保留六个月。欧盟,2024 年;《人工智能数字综合法》(条例 (EU) 2026/1744,2026 年 7 月 27 日生效)将附录 III 领域的高风险适用期推迟至 2027 年 12 月 2 日,将嵌入受监管产品中的 AI 适用期推迟至 2028 年 8 月 2 日。
来源与溯源信息
归属: European Union
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
首个可认证的 AI 管理体系标准,设定了在 AI 全生命周期中建立、运行和改进治理控制措施的要求,包括风险评估、影响评估及绩效度量。ISO/IEC JTC 1/SC 42,2023 年。
来源与溯源信息
归属: ISO/IEC JTC 1/SC 42
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对 AI 系统的对抗性战术与技术动态知识库,参考 MITRE ATT&CK 构建,源于真实世界攻击与红队实测演练。MITRE,v2026.07(2026 年 8 月 7 日):包含 16 项战术、101 项技术、77 项子技术、37 项缓解措施与 68 个案例研究,新增了三项 AI 智能体工具投毒子技术(AML.T0110.000/.001/.002)以及 AML.T0115。
来源与溯源信息
归属: MITRE
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
社区维护的语言模型与智能体应用风险清单,涵盖提示词注入、过度自主(excessive agency)、工具滥用、记忆与上下文污染以及目标劫持,附有面向构建者的技术建议配套指南。OWASP,2025 年(LLM)/ 2026 年(Agentic)。
来源与溯源信息
归属: OWASP
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
将提示词注入列为可映射软件弱点的基础级弱点条目,附有 LangChain 工具智能体示范案例。MITRE CWE 4.20,映射状态为 ALLOWED。
来源与溯源信息
归属: MITRE
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
构建者可针对智能体架构运行的七层威胁建模方法。云安全联盟(CSA),2025 年;属于单作者博客文章而非正式批准的标准,因此其证据层级低于上述 NIST、ISO、MITRE 与 OWASP 条目。
来源与溯源信息
归属: Cloud Security Alliance
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
独立治理提案,将智能体监督划分为五个层级,明确了证据收集与完整性控制,对机制背后的证据与设计推断进行了评级,并实行公开证据纠错流程。ZhangRui987,2026 年;属于设计提案而非正式批准的标准或经评估的实现,因此与上述 MAESTRO 一样处于较低的证据层级。
来源与溯源信息
归属: Zhang Rui (ZhangRui987)
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
经过密码学签名、防篡改的元数据标准,用于记录媒体的来源与编辑历史,包含针对 AI 生成与 AI 编辑内容的清单。C2PA(由 Adobe、微软、BBC、英特尔、Truepic、索尼等发起),v2.2(2025 年)。
来源与溯源信息
归属: Coalition for Content Provenance and Authenticity (C2PA)
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
仅追加的默克尔树日志,具备证明条目存在于日志中的包含性证明(inclusion proof)和证明日志仅被追加的一致性证明(consistency proof);是防篡改智能体追踪所复用的可验证日志模式的起源。IETF,2013 年(v1)/ 2021 年(v2)。
来源与溯源信息
归属: IETF
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
经签名的机器可读声明,将目标工件与描述对其所执行操作的谓词绑定起来,为跨步骤和工具的出处溯源声明提供了通用封装机制。in-toto / CNCF,2018-2026 年(动态规范)。
来源与溯源信息
归属: in-toto / CNCF
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
分级的框架,界定了构建必须生成何种出处血缘以及防篡改程度,各级别均给出了具体明确的要求而非泛泛意图。OpenSSF,v1.0(2023 年)。
来源与溯源信息
归属: OpenSSF
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
对有效载荷连同其类型一同鉴别的签名封套,消除了因规范化歧义导致签名可针对相同字节的不同解释进行重放的隐患;由 in-toto 与 Sigstore 使用。Secure Systems Lab,2021-2026 年。
来源与溯源信息
归属: Secure Systems Lab
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目
针对已签名软件工件和证明声明的透明度日志服务,构建于仅追加的默克尔日志之上,通过公开 API 提供包含性证明与一致性证明。Sigstore / OpenSSF,采用 Apache-2.0 许可,2020 年至今。
来源与溯源信息
归属: Sigstore / OpenSSF
审核状态: 于 2026-09-16 对照目录快照完成核对(外部链接未进行运行时验证)。
目录来源: Awesome Auditable AI 条目