

AISI 发布的内容
2026年8月27日,英国人工智能安全研究所(UK AI Security Institute)发表了一篇
博文,
介绍了 optstop,这是一个将贝叶斯最优停止理论应用于大语言模型(LLM)评估的开源 Python 软件包。该发布随附了 Toby D. Pilditch 于2026年8月14日提交至 arXiv 的预印本论文
Knowing When to Stop: Bayesian Optimal Stopping for LLM Evaluations,
以及一个公开代码仓库。
该工具通过少量配置添加即可与 AISI 的 Inspect 评估框架集成。其出发点在于解决实际的资源瓶颈:固定预算的评估往往把算力浪费在特征已非常明确的任务-模型组合上,而更难解决的边缘案例却可能在资源耗尽前未能得到充分检验。
optstop 的工作原理
optstop 跟踪当前性能估计值周围的可信区间。当该区间收窄至预设阈值(精度规则)或停止变化(稳定规则)时,它便停止采样。如果两条规则均未满足,则评估将运行至全部计划预算。保守机制要求在估计成功率低于 1% 时获取额外数据,以防在罕见事件场景下过早停止。每一次停止决策均会被记录在日志中。
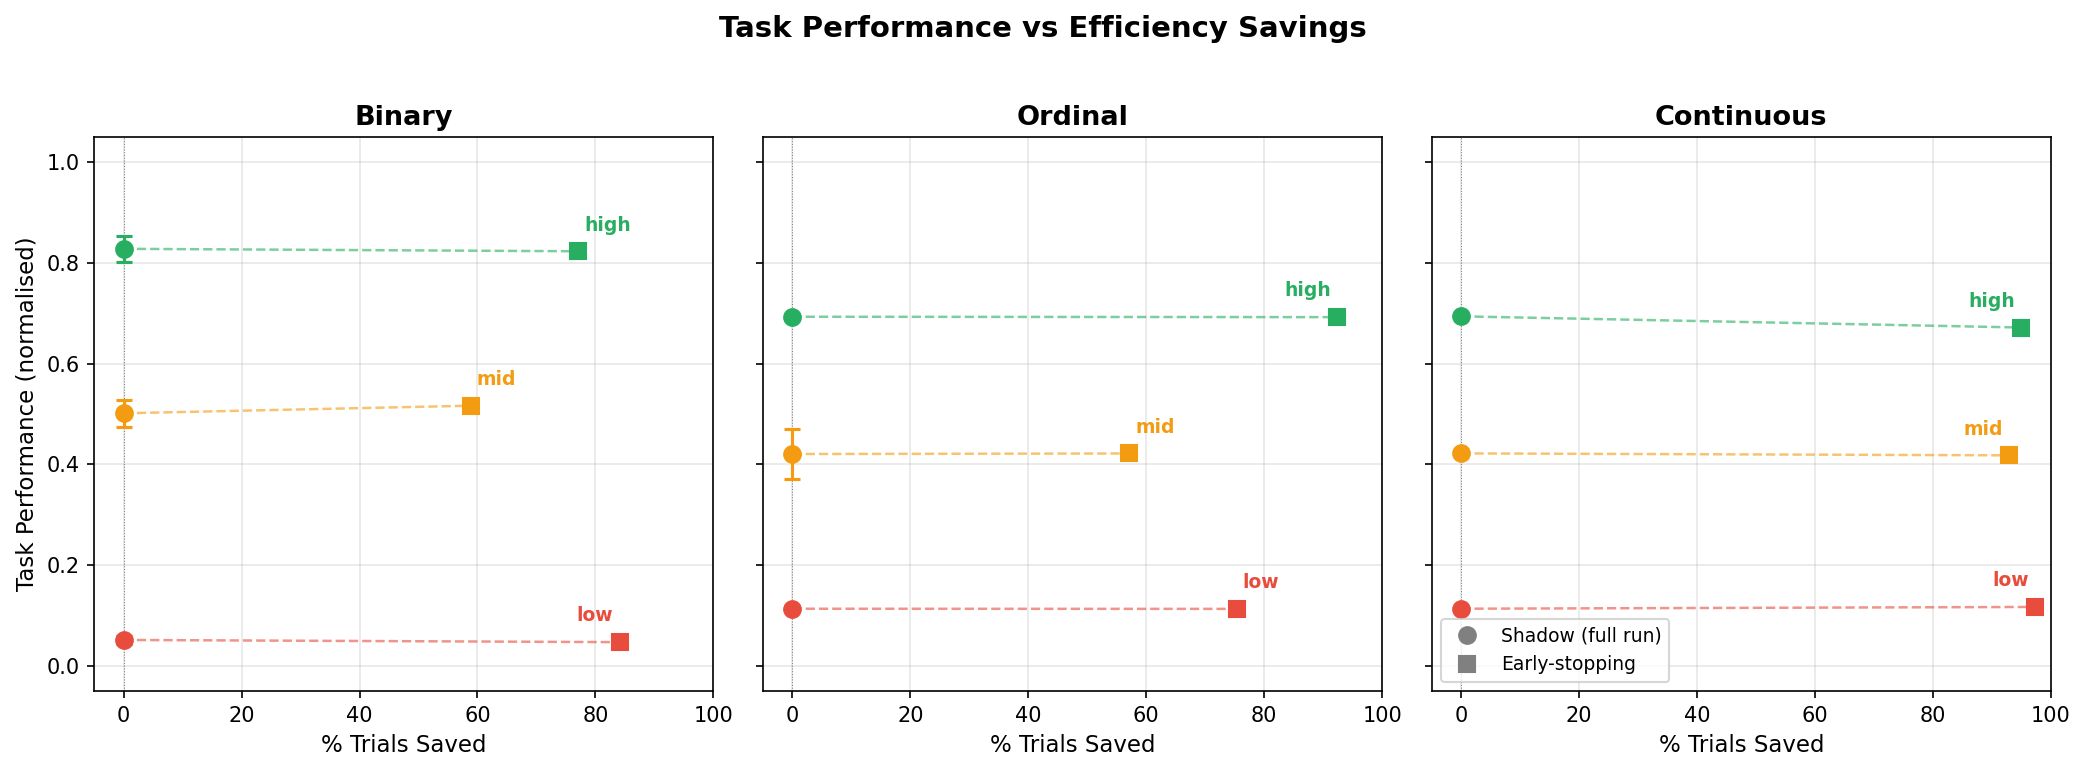
在包含 200 个测试项和 10 轮迭代的九种验证设置下,该 论文报告节省了 57% 至 97% 的计划试验轮次, 且评估结论与完整运行保持一致。这些属于报道所引述的验证结果, 并不保证其他评估也能获得同样的算力节省。采用过程可以循序渐进:事后验证(在已完成的评估上运行以验证一致性)、影子模式(记录早停建议但不付诸执行),最后再正式启用。
局限性
节省幅度取决于评估设计、模型以及精度阈值。该工具目前要求任务按随机顺序排列;非随机队列可能会使早期估计产生偏差。针对罕见成功设置的防护机制解决了一个重要的边缘情况,但并未消除自适应早停带来的所有风险。
- 博客:AISI,2026年8月27日
- 论文:arXiv:2608.14425(2026年8月14日提交)
- 代码:github.com/UKGovernmentBEIS/optstop
关注 Audit Commons
在您的阅读器中及时获取最新报道、实践指南与精选资源。