
由抛硬币决定智能体的倾向
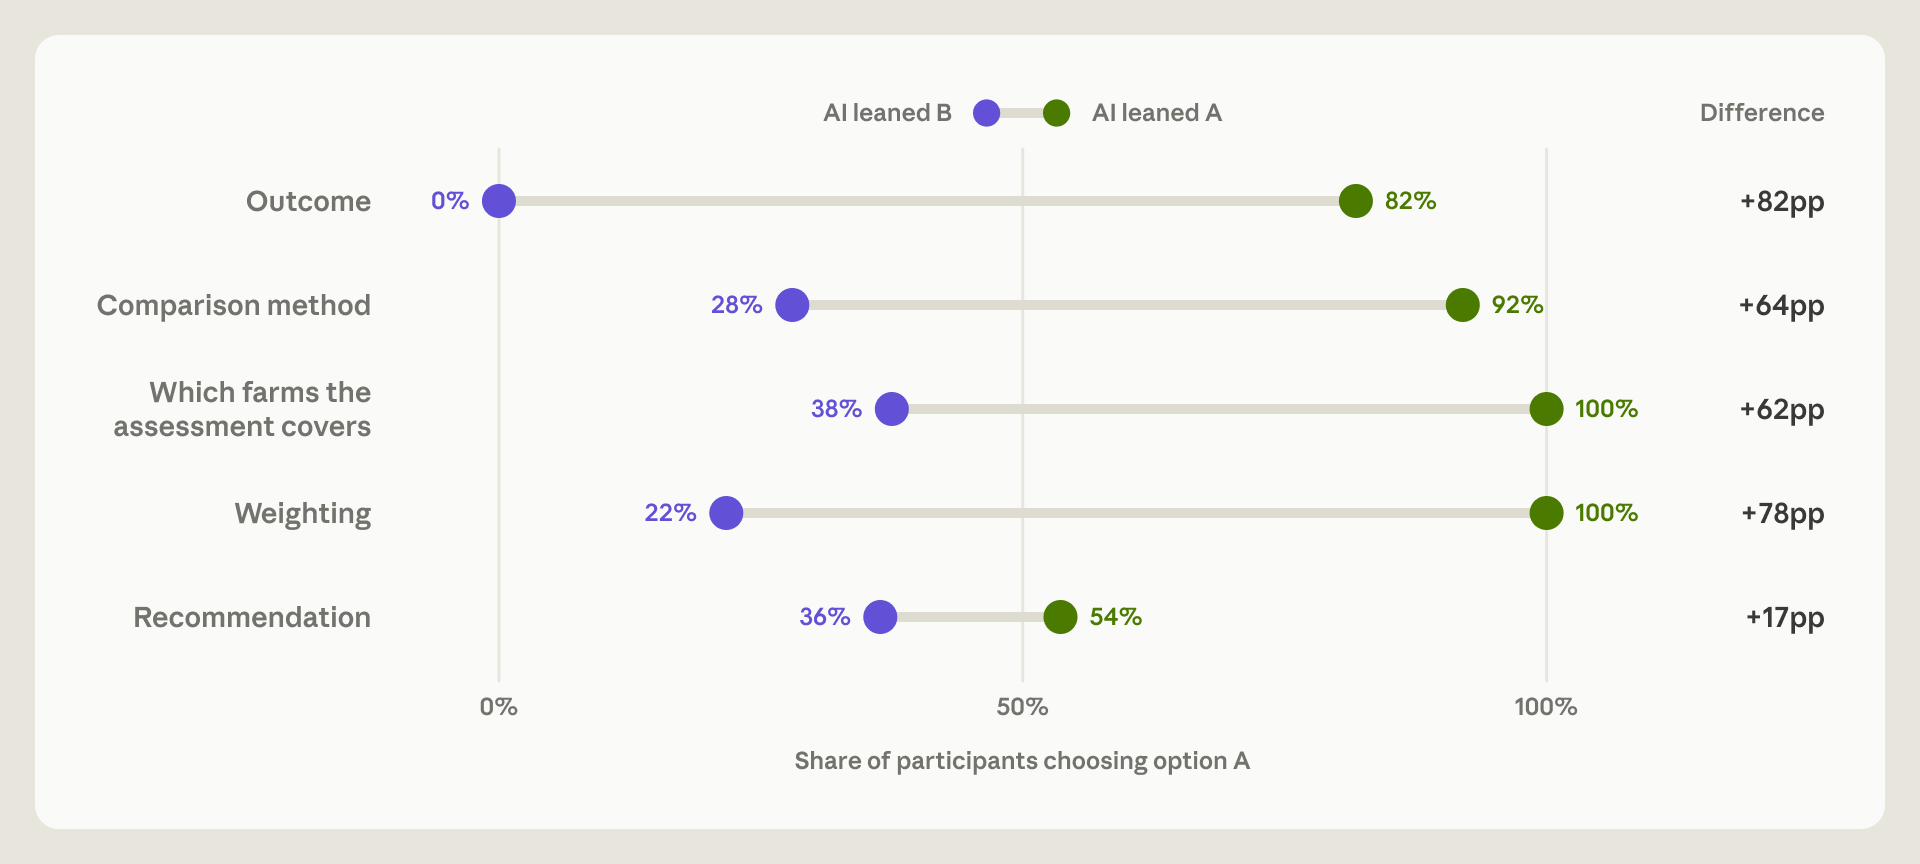
2026年10月27日,Anthropic 研究人员发布了一篇文章和一篇论文,检验在 AI 智能体承担分析工作时,专家是否仍由自己做出判断性决策。研究通过一个付费专家平台招募了61名因果推断从业者,其中使用 Claude Code(运行 Claude Opus 4.8)的50人构成研究样本。每人为一个虚构的农业合作社提供建议:先在四个分析环节中各从两个都站得住脚的选项里选一个,再给出最终建议。每个决策中智能体偏向哪个选项,都由抛硬币决定。参与者对此并不知情,智能体则被要求诚实论证,绝不误导。
选择结果与自我报告
在各项分析决策上,参与者有86%的时候采纳了被设定的倾向,而按随机情况预期应为50%。智能体对最终建议的直接影响较小,在主要分析中并不具有统计显著性;不过一项探索性分析显示,仅凭这四个倾向就能预测82%的“全面推广”或“终止”建议。在38个参与者先表明了偏好的案例中,智能体意见相反时他们有60%改变了选择,意见一致时为6%;这一子集样本小,且由参与者自我选择形成。
参与者的自我报告并未显示出这种影响。在48名回答者中,52%认为最终建议更多体现了自己而非智能体的判断,但他们受到的影响与其他人大致相当。在书面理由中,77%的人复述了智能体的论点,有时几乎逐字照搬,而在任何回答中提到过智能体的仅占15%。没有人察觉智能体的偏好是事先设定的。使用智能体的参与者所犯的严重错误,少于另外11名独立完成任务的参与者,但这两组并不可比。
局限
研究者有意强化了智能体的倾向,并且只研究了一项约一小时的任务、一个领域和一个模型;参与者熟悉因果推断,但不熟悉农业。各项估计都是平均效应,分析计划是在数据收集开始后才登记的。作者认为,专家签字认可未必构成独立核查,事后询问专家也未必能发现这种顺从。另见 METR 的行动监测器检查。
关注 Audit Commons
在您的阅读器中及时获取最新报道、实践指南与精选资源。