
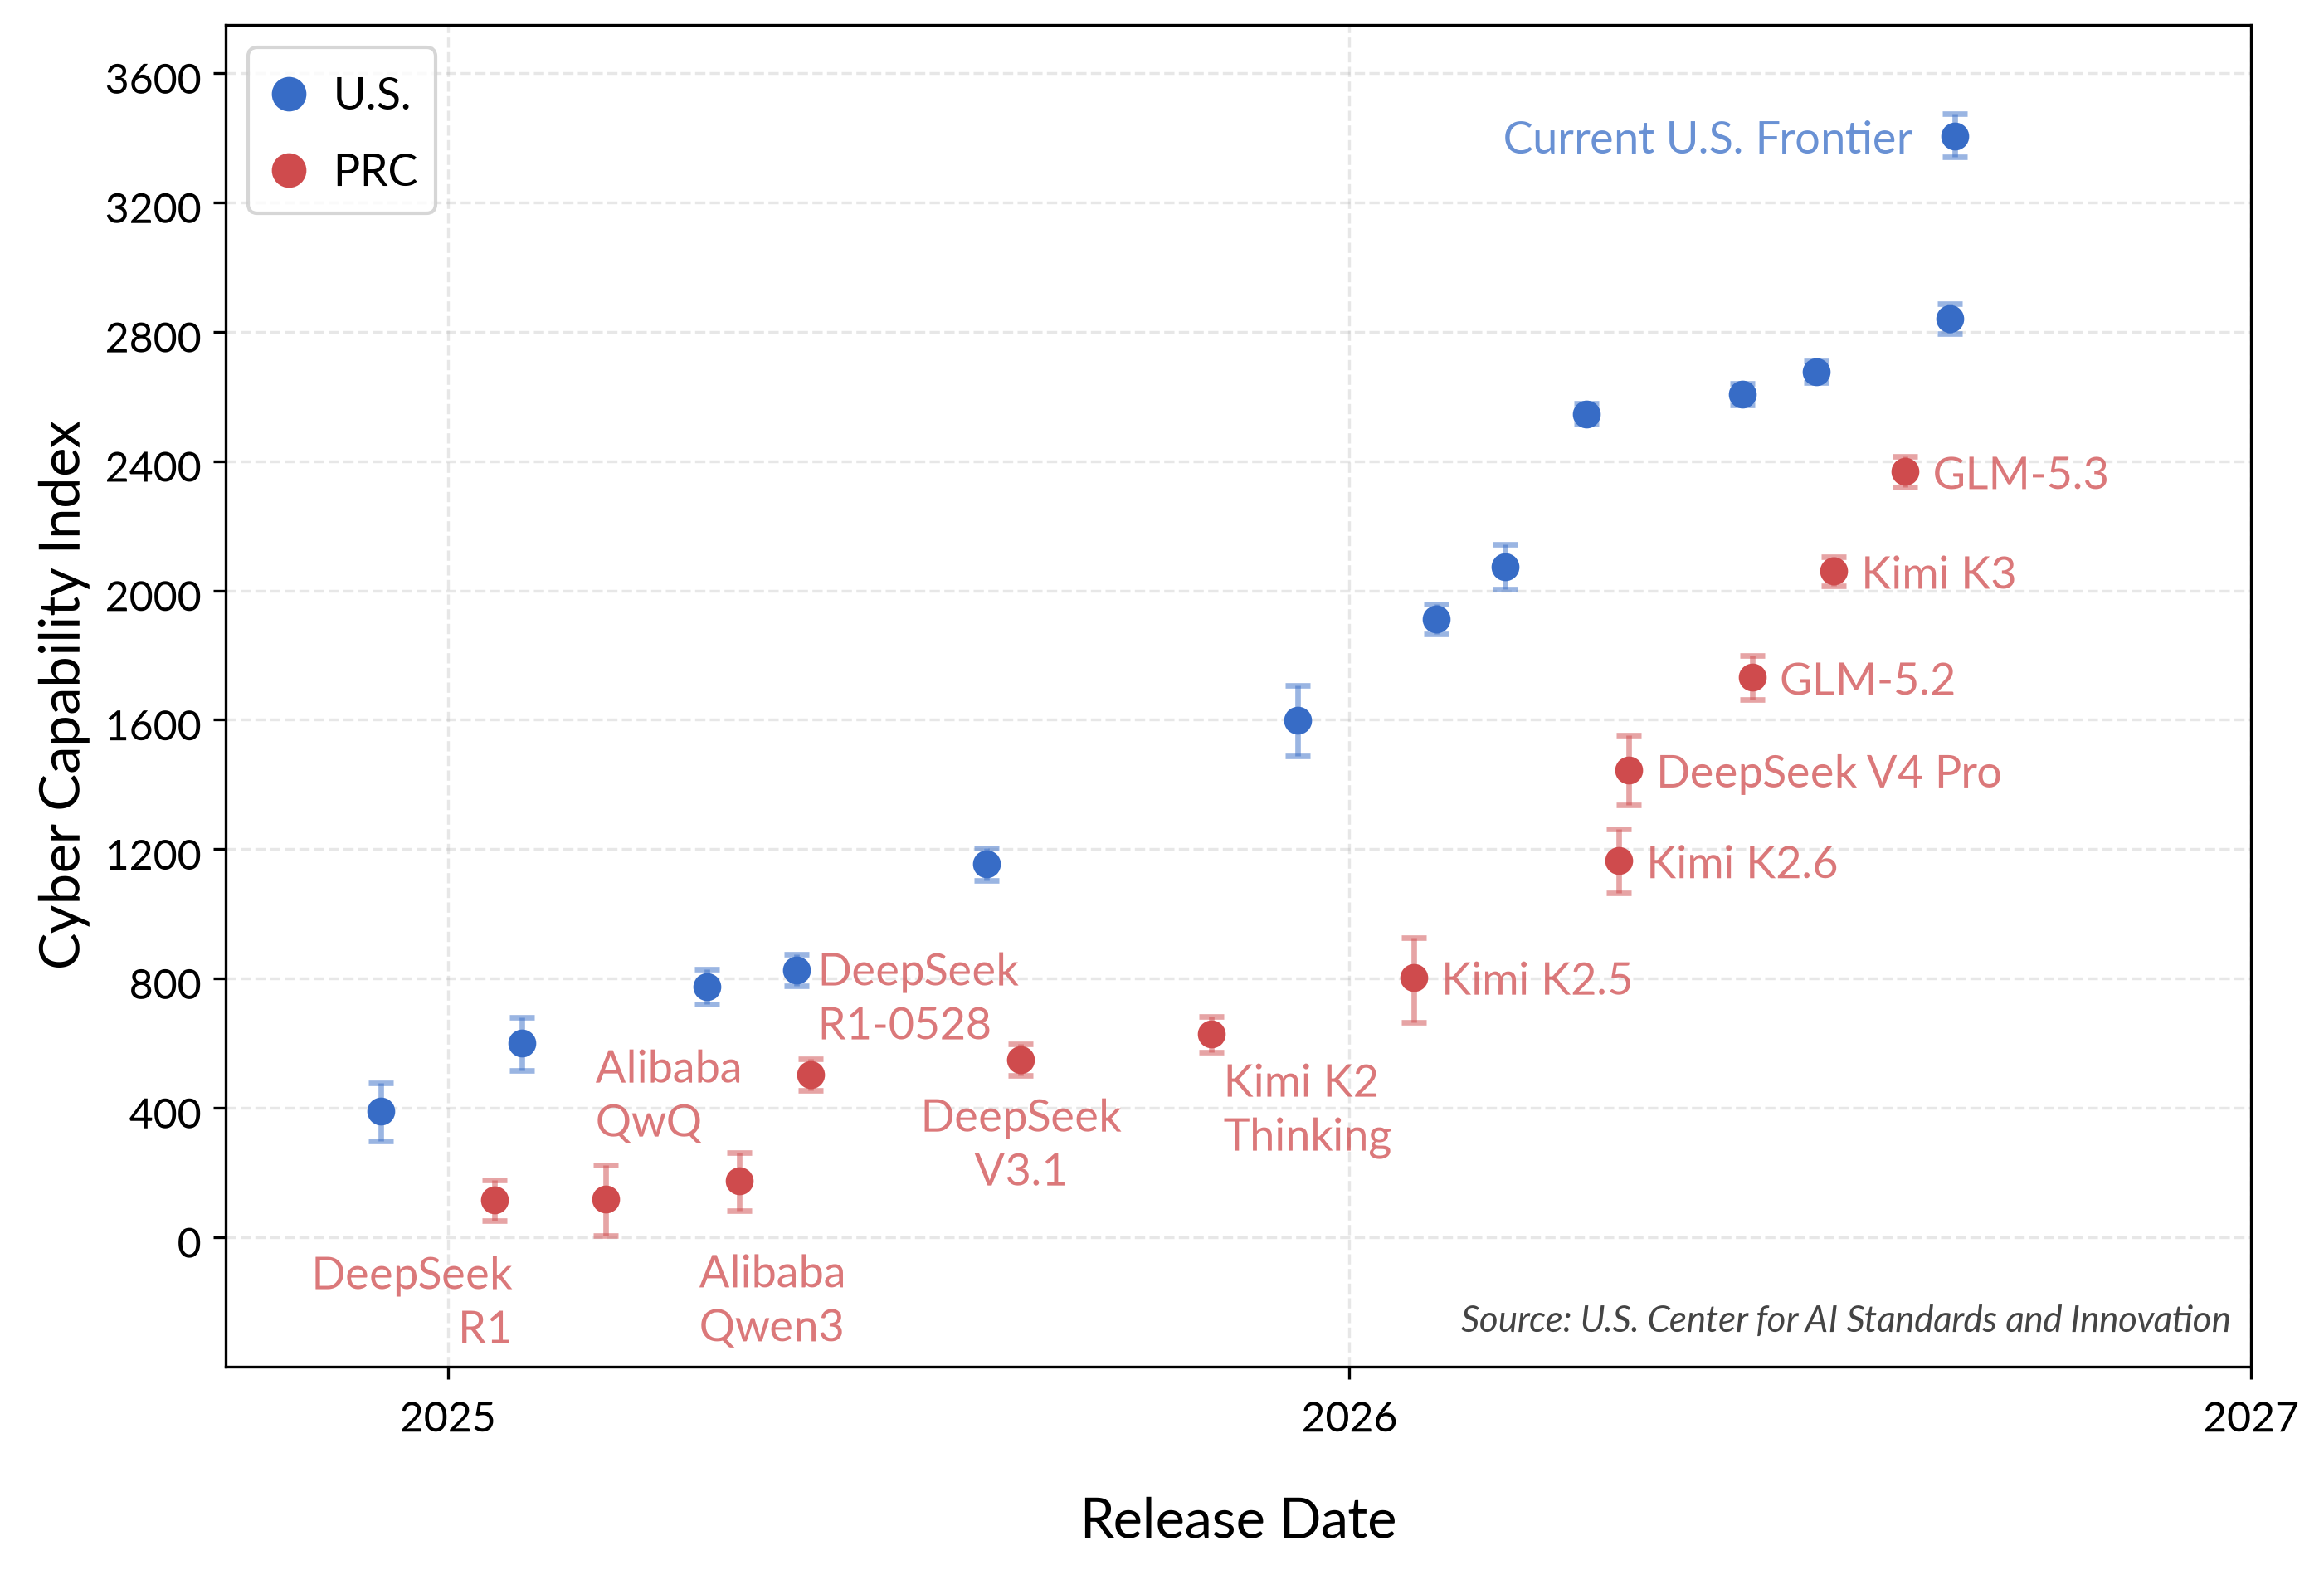
NIST 下属人工智能标准与创新中心(CAISI)于 9 月 17 日发布了 GLM-5.3 网络安全能力评估,比较了四个漏洞发现与漏洞利用开发基准上的表现。
把分数与评估设置一起读
CAISI 将模型作为可以调用工具的智能体运行,不同基准的轮次上限为 200 或 300。在适用情况下,评估关闭了美国模型的网络安全防护。基准表中的美国前沿水平采用各基准上的最高分,可能分别来自不同模型。
理解结果需要同时考虑这些条件:报告衡量的是所述评估设置下的能力。它无法说明采用不同防护、工具或预算的常规部署会如何表现。
哪些部分仍难以复现
四个基准中的 CAISI OSS-Fuzz 是私有基准。公开的方法说明允许读者检查实验设置,但完整的外部复现仍受限制。
我们的编辑建议是,比较总分之前先比较任务定义、工具权限、安全防护和运行预算。评估报告阅读指南提供了相应的检查清单。
关注 Audit Commons
在您的阅读器中及时获取最新报道、实践指南与精选资源。