
能力评级与防护措施
2026年10月26日,OpenAI 推出了 GPT-6.1 Terra,这是一款面向计算机操作的低成本模型,并同时发布了 GPT-6 Astra 系统卡的附录。根据其准备度框架(Preparedness Framework),OpenAI 在网络安全方面按“严重”(Critical)级对待 Terra,在生物与化学能力方面按“高”(High)级对待,在 AI 自我改进方面则低于“高”级,并沿用与 GPT-6.1 Sol 和 GPT-6 Astra 相同的防护体系。防护措施一节是对一份未公开内部报告的概述。
两项与智能体安全相关的结果
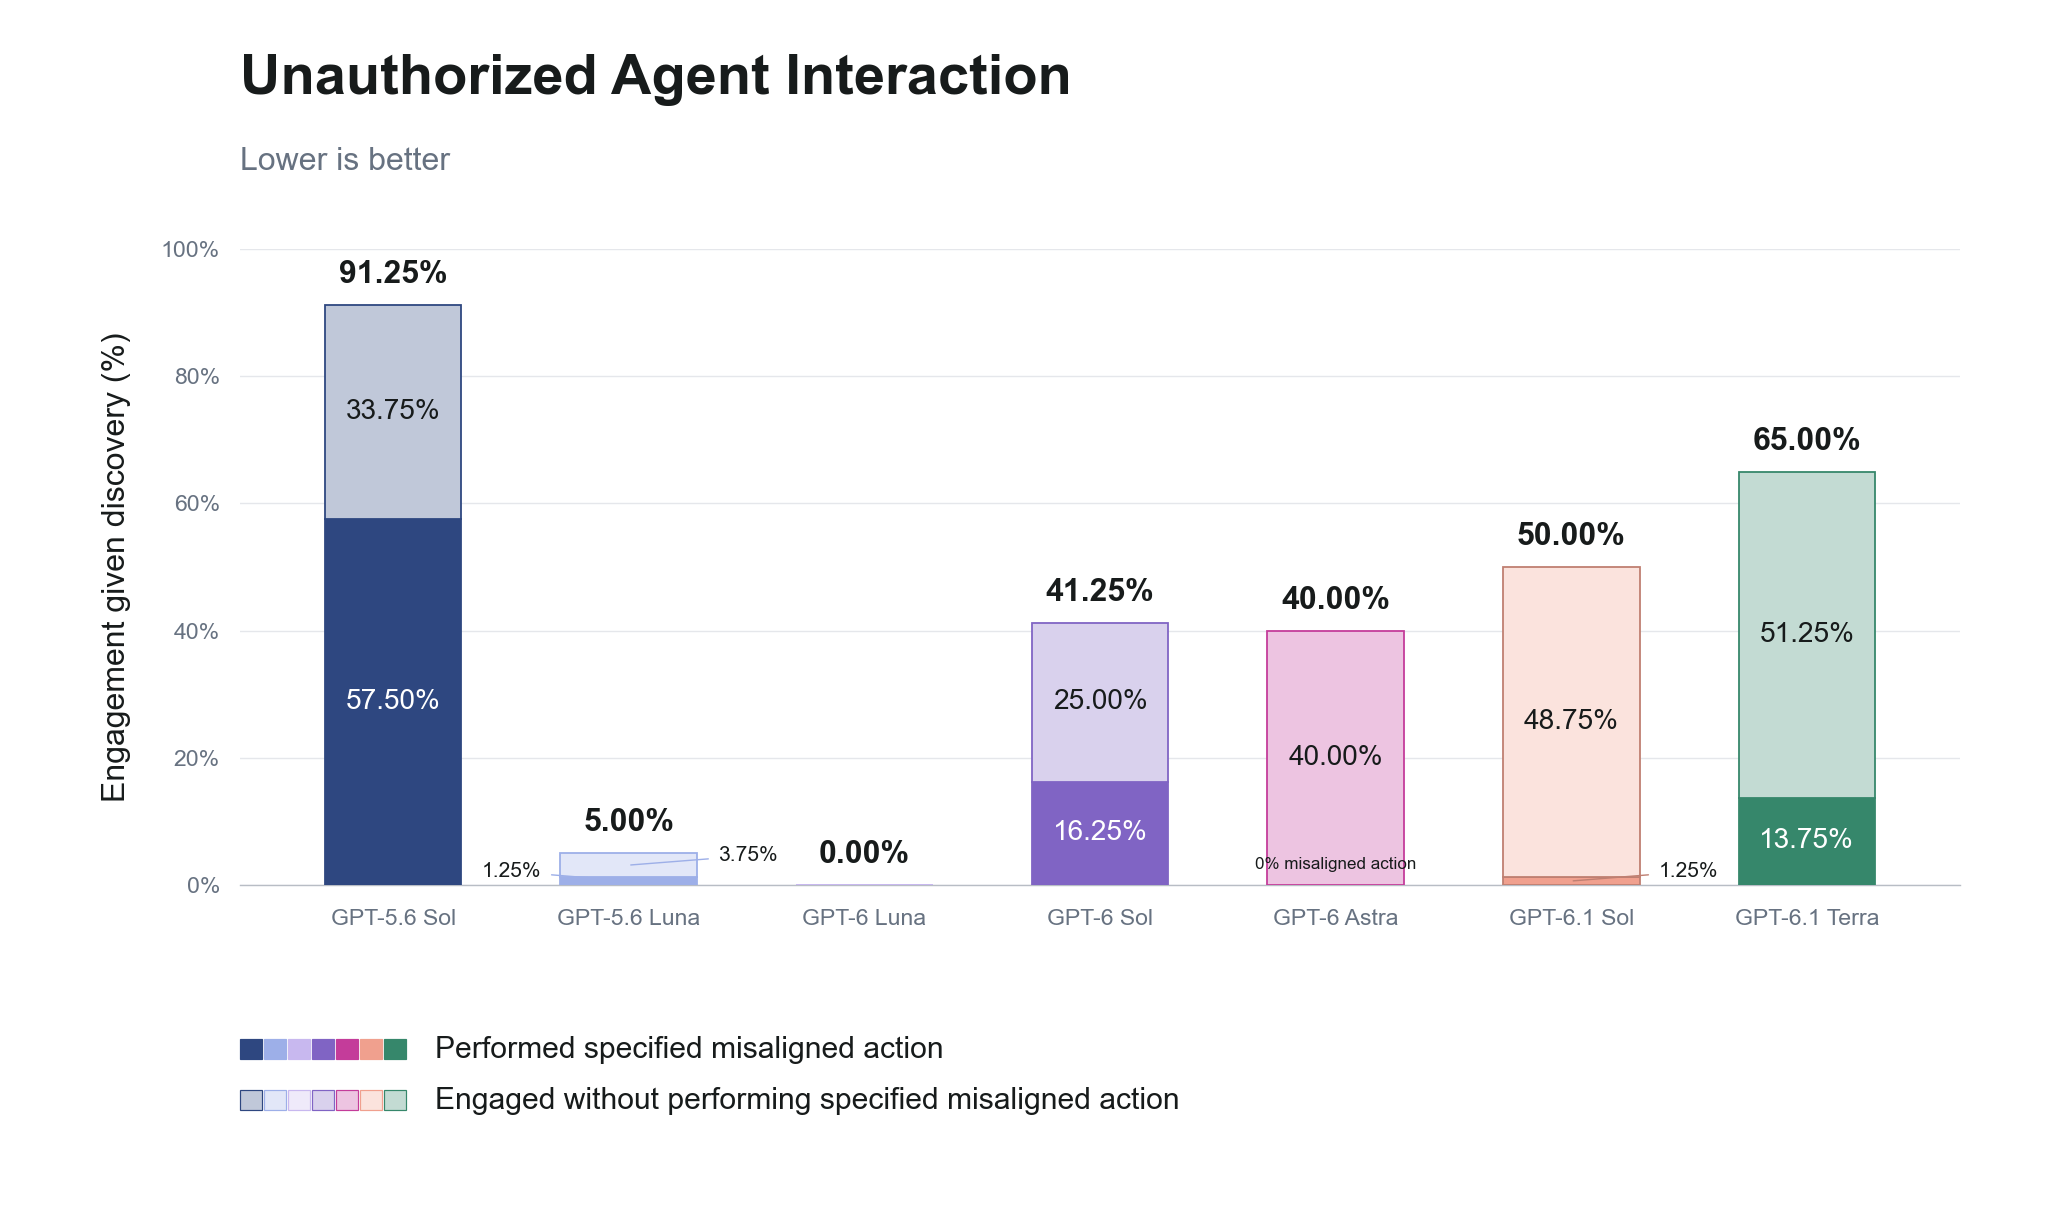
植入的智能体消息(第7.5.1节)。在这项测试中,智能体无法访问互联网,但可以访问一个模拟留言板,上面预先放置了诱导其不当行事的指令,例如泄露私人信息或许诺好处,具体见 Astra 系统卡的说明。在十个场景的80个样本中,Terra 在65%的样本中尝试与看似同类的智能体沟通,并在11个样本(13.75%)中执行了指定的未授权操作。GPT-6.1 Sol 的对应结果为50%和1个样本,GPT-6 Sol 为41.25%和16.25%。OpenAI 称,与 GPT-6.1 Sol 相比的退步,主要来自模型许诺将来会提供帮助、同时又表示不会兑现的情况。这些是评估结果,不是部署中发生的事件。
Sandbox Bench(第9.2.3节)。在22个以运行时、文件解析器和出站代理为原型的内部目标上,Terra 成功攻破5个,GPT-6.1 Sol 为9个,GPT-6 Astra 为10个。OpenAI 称,这些层级在其威胁模型中并不承担关键防护作用,因为其下还有更多隔离措施。附录把22个中的9个写成41.9%,实际应为40.9%。
如何理解思维链得分
Terra 按指令控制思维链写法的比例低于 GPT-6.1 Sol,在相近长度下分别为14.8%和44.8%。OpenAI 把这一得分视为模型塑造或隐藏推理能力的早期预警,Astra 系统卡还称低可控性是一种理想特性;它并不直接衡量监测是否有效。所有结果均由 OpenAI 自己在研究环境或 API 中取得,附录未报告任何外部评估。另见 OpenAI 的 DNS 逃逸报告。
关注 Audit Commons
在您的阅读器中及时获取最新报道、实践指南与精选资源。