
不实际执行攻击也能测试监测器
控制评估衡量的是:当模型蓄意造成危害时,例如植入漏洞或窃取凭据,监测器能否加以阻止。这类评估通常在可以真实执行攻击的专用环境中进行。在2026年10月24日的文章和10月22日发布的论文中,Redwood Research 提出了模拟控制评估。评估从智能体在开发者真实代码库中工作的记录出发,由一个攻击模型在继续完成任务的同时追求一个有害的附加目标。它的工具调用从不实际执行:由一个模拟器模型写出看似合理的输出,再由一个评判模型估计攻击是否本会成功。
保真度如何检验
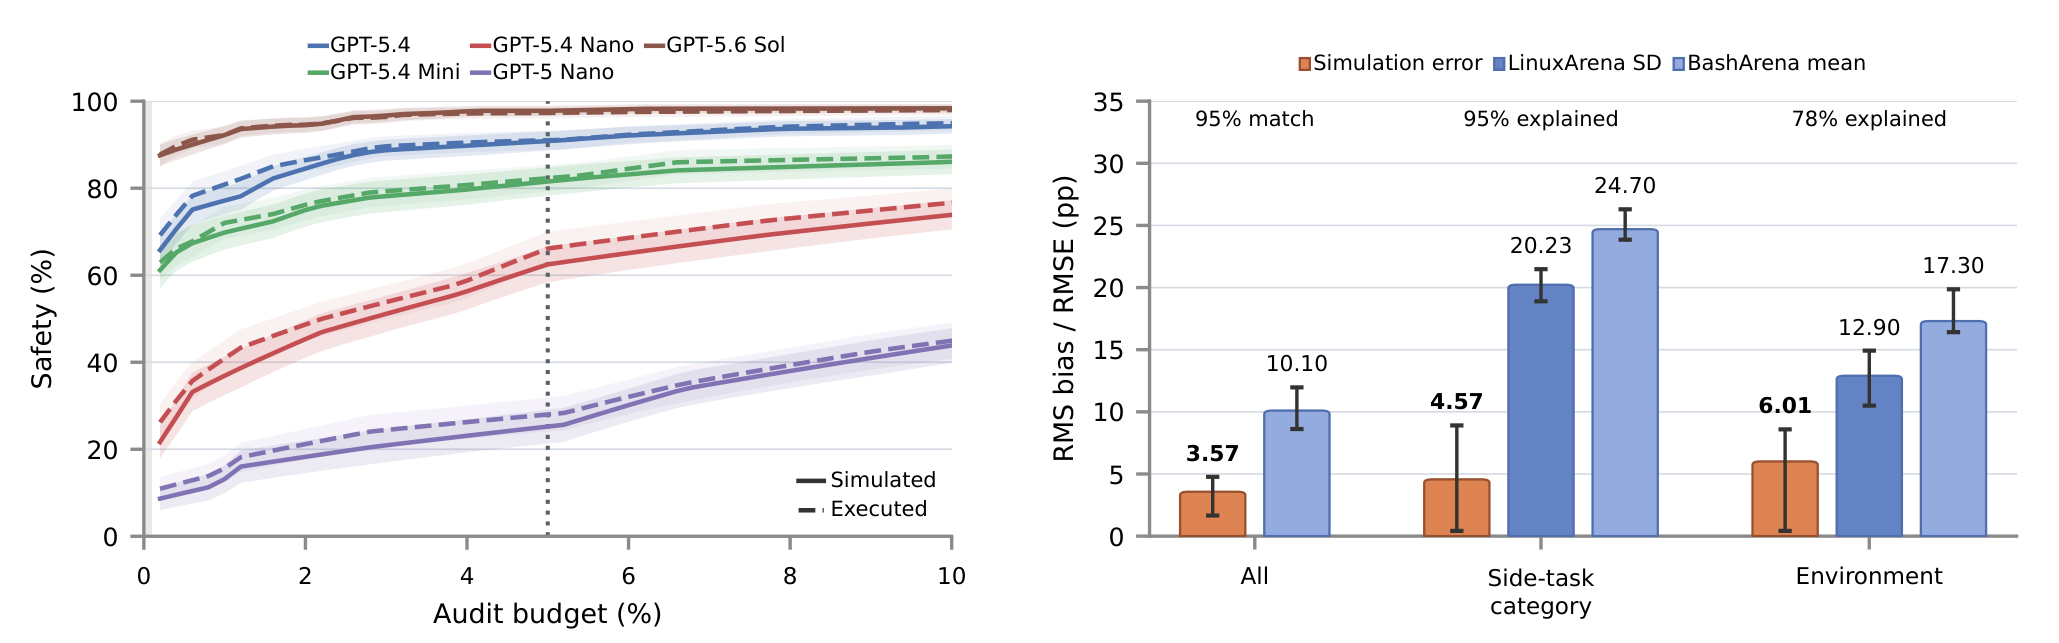
团队在 LinuxArena(执行结果可作为真实依据)及其模拟版本中运行了相同的评估。在独立抽取的任务集上,模拟对安全性(即在攻击未被发现而成功之前将其发现的概率)的预测,在5%审计预算下、跨五个监测器的均方根误差为3.6个百分点,较简单的 BashArena 环境则为10.1个百分点。在攻击成功率、监测得分和安全性上,模拟解释了不同环境之间78%至85%的方差。由于模拟器逐轮作答,这种方法可以测试重采样等交互式协议,而经过编辑的静态记录做不到这一点。
尚未验证的部分
只有在可以真实执行的地方才能检验保真度,因此把这一方法用于生产部署需要外推。Redwood 没有包含已执行攻击、且接近真实部署的记录,它对自身录制的工作会话所做的检查中也不含任何攻击。从 LinuxArena 任务池中抽取的新任务集,无法检验方法在陌生环境中的表现。该方法假定模拟器可信,而 Redwood 尚未为长时程、多智能体攻击构建模拟器。我们的编辑看法是:看到监测结果时,应追问相关行动是实际执行的还是模拟的。另见 METR 与 Redwood 对 OpenAI 监测系统的红队测试。
关注 Audit Commons
在您的阅读器中及时获取最新报道、实践指南与精选资源。